


AI+DevOps是噱头还是刚需?企业落地实践分析
AI+DevOps是噱头还是刚需?本文分析落地差距:70%企业引入AI仅15%体系化落地,代码审查、流水线诊断等场景已有量化收益,附真AI鉴别五维度与单环节试点落地路径。
AI 编程工具普及后,开发者在写代码环节的效率提升很容易被感知。但需求、代码、构建、制品、发布仍彼此割裂——需求变更要人工同步、构建失败要逐个排查、发布结果难以回溯。AI 让写代码变快了,交付链路却没快,「噱头」情绪往往由此而来。
更准确的问题不是「要不要用 AI」,而是 AI 嵌在交付链路的哪一环、数据是否同源、能否用基线量化 ROI。下文给三样可直接用的:三个可先试点的环节、一张识别真 AI 能力的五维鉴别表、一条从试点到扩展的路径。核心判断一句话:先单环节试点,再用数据决定是否扩展全链路。
常见断点之一:团队上了 Copilot 后 MR 量上升,评审仍靠人肉逐行看 diff——瓶颈从「写得慢」变成「审不过来」。此时再买一个「AI 写代码」工具,往往解决不了交付问题;更稳妥的试点对象,是评审或流水线诊断这类数据结构化、反馈快的环节。
一、AI+DevOps 是噱头还是刚需:先看融合深度
把「AI+DevOps 是噱头还是刚需」当作非此即彼,容易误判。单点尝鲜——只在 IDE 里用 AI 写代码、工程链仍多系统拼接——很难看到全链路收益,容易得出「噱头」结论;若 AI 嵌在 有数据关联 的环节(MR、构建日志、发布记录同源),并用基线衡量前后变化,则多数团队会把它视为 可计算的增强,而非伪需求。
公开调研里有一个常被引用的对照(口径为 企业级 AI 成熟度,非 DevOps 专属):ServiceNow《Enterprise AI Maturity Index 2025》显示,多数受访企业已开始试点 AI,但实现体系化落地的仍是少数(具体比例以报告原文为准)。信通院 DevOps、研发运营一体化(XOps)相关公开材料也反复提到:行业正从单点工具试用走向工具链整合与流程协同(具体表述以当期公开版本为准)。差距主要在 AI 与研发数据、流程的融合深度。
观察 | 含义 | 对 AI+DevOps 的启示 |
引入比例高、体系化比例低 | 瓶颈多在落地方法,而非模型能力本身 | 别先谈「全链路 AI」,先选可量化的一环 |
单点工具体验好 | 写代码快,不代表交付快 | 试点应选在 链路内有结构化数据 的环节 |
缺少基线与 ROI | 「用了也无感」 | 试点前记录评审时长、构建失败定位时间等基线 |
与其问「要不要上 AI DevOps 平台」,不如问:当前最痛的断点在哪一环,该环的数据是否完整、反馈是否够快、出错是否可逆。
二、三个可先试点的环节
不是所有环节都适合先做 AI。优先选 数据完整、反馈闭环短、风险可逆 的场景;下列三类在公开实践与团队试点中最常见,细节深度见专文或须自建基线验证。
1. 代码审查:机器标记,人做决策
对 MR/PR 做初筛,标记潜在缺陷与规范偏离;人保留合入与定级权。适合作为起点的常见原因:变更有 diff、结果可量化(评审时长、漏检/误报趋势)、错误后果相对可控。MR 分工、推送前与 MR 两关口、意见如何进缺陷闭环,见同系列《AI 辅助代码评审:机器先扫,人做判断》。一体化 DevOps 平台(如 GitFox 与禅道需求/缺陷联动)若将 AI 评审与 MR、流水线记录同源,便于追溯与 ROI 统计;是否适用,须试点验证。
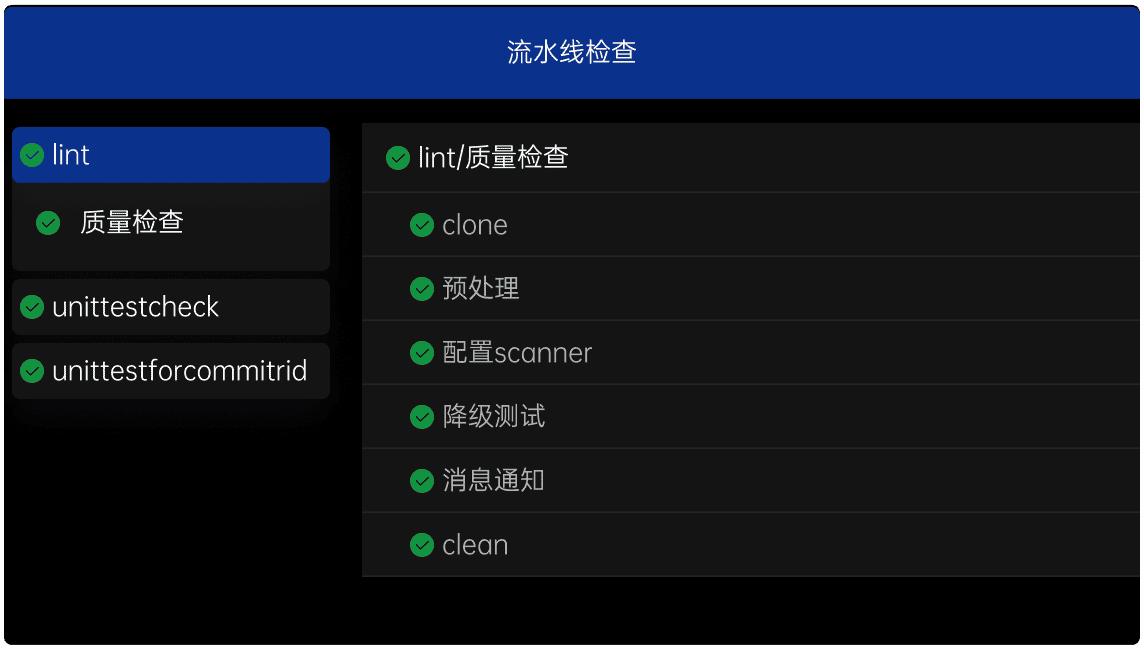
2. 流水线诊断与故障定位:压缩 MTTR
构建失败、测试 flaky、环境漂移时,AI 可辅助聚合日志、关联近期变更与构建号,缩短「从告警到根因」的路径。前提是 日志、构建记录、代码变更、环境状态能关联;多套工具拼接时,往往要先补数据同步层,AI 才有上下文可读。关键操作(回滚、扩缩容、改生产配置)宜保留人工审批,从只读诊断、建议级输出起步。
3. 发布与制品质量控制:让变更可预判
AI 可辅助变更影响面梳理、制品版本一致性核对、发布前风险清单,但 不等于自动放行。发布单、制品 ID、关联测试与审批记录须结构化;否则 AI 只能给泛化建议。这是行业演进方向,不代表任一平台已默认具备;有无此类能力、是否需外接模型,须 PoC 用真实发布数据验证。
三、如何辨别真 AI 能力与包装概念
选型或 PoC 前,可用下面五维做快速核查。
检查维度 | 伪装信号 | 有效信号 | PoC 怎么验 |
数据接入 | 只在对话框问答,读不到仓库与流水线 | 可读取代码变更、构建、制品、发布等授权数据并关联 | 用真实 MR/构建跑一轮,看结论是否引用具体 ID |
输出闭环 | 只给文字建议,需人工去另一系统操作 | 在权限内可创建评论、MR 状态、工单或触发流水线 | 统计「建议→动作」是否在同一平台完成 |
结果可追溯 | 无法说明依据 | 结论可回溯到文件、构建号、制品或变更记录 | 随机抽 3 条 AI 输出,能否定位来源 |
人审机制 | 无复核入口、自动合入 | 明确「AI 标记、人决策」,关键步骤可审计 | 检查权限模型与审批留痕 |
规则可控 | 黑盒不可配置 | 可通过规则集/策略对齐团队规范与误报治理 | 试点 1~2 周,记录误报并能否写入排除规则 |
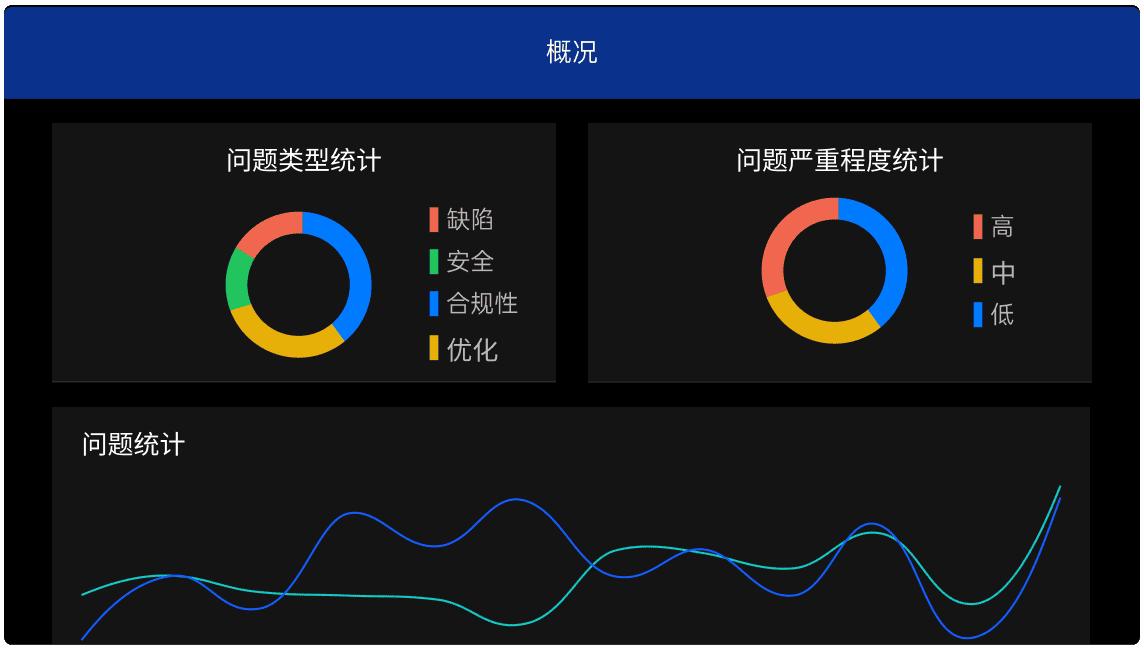
能持续输出 评审时长、缺陷发现率、误报率、MTTR 等趋势的平台,更接近「嵌在流程里」的 AI;只能演示 Chat 窗口的,多半仍是外挂。
四、落地路径:单环节试点 → 数据评估 → 再谈全链路
1. 选环节
按第二节的三条标准圈定候选环节。代码审查、只读型流水线诊断是常见起点;勿在数据未打通时同时开三个 AI 项目。
2. 建基线,跑 2~4周
试点前记录当前值,例如:平均 MR 评审时长、高危问题漏检样本、构建失败平均定位时间、发布回滚次数。试点期固定规则配置与人员范围,避免「规则天天改、数据不可比」。
3. 打通数据链路(AI 生效的前提)
AI 价值与 需求—代码—构建—制品—发布 的关联程度正相关。一体化底座,或 PM 与 DevOps 原生集成 的组合,通常比多系统 Webhook 拼接更易做追溯与度量;多套工具方案则需额外建设同步层与接口维护。GitFox、GitLab、Azure DevOps 等仅作路径举例,是否降低整合成本须用目标环境 PoC 对比。
4. 用指标说话,再决定是否扩展
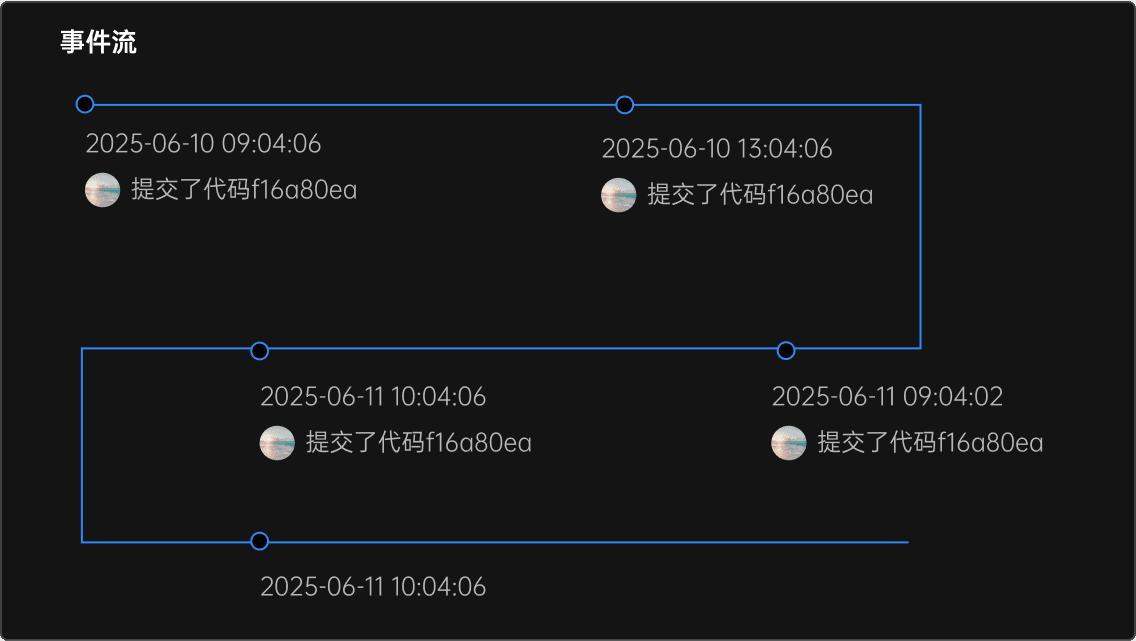
以 DORA 四类指标(部署频率、变更前置时间、变更失败率、恢复时间)观察交付侧变化——指标用于验证改进,不作某一家产品的背书。叠加 AI 专项指标更利于算单环节 ROI:
交付效率: 变更前置时间、部署频率
稳定性: 变更失败率、MTTR
AI 专项: 评审时长、高危发现率、误报率、构建失败定位时长
AI 定位为 增强系统:关键发布、权限变更、生产回滚仍须人工审批;把 AI 使用边界写入团队规范。单环节 ROI 算得清,再决定是否扩展到告警聚合、发布辅助等链路;算不清时,不宜为了「AI DevOps」名目做大而全采购。
五、结语
AI+DevOps 是噱头还是刚需,取决于落地方式: 单点尝鲜、数据割裂,容易像噱头;在可验证环节嵌入流程、用基线衡量收益,则更接近刚需。
如果现在就想动手,按一个月走完:第 1 周圈定一个数据完整的环节,记下基线(评审时长、构建失败定位时长);第 2~3 周固定规则配置、跑真实数据,用第三节五维表逐项核查;第 4 周把前后指标摆在一起,ROI 算得清就扩展,算不清就停下。候选方案的 AI 能力说明并列对比,以实测为准。
常见问题(FAQ)
Q1:AI DevOps 是伪需求吗?
不是。代码审查、构建诊断等环节在试点中常能观察到可量化改善;「伪需求」印象多来自 只在 IDE 用 AI、工程链未打通。建议先单环节试点,再谈全链路。
Q2:小团队需要 AI DevOps 吗?
视瓶颈而定。评审积压、流水线频繁失败、发布难追溯,就值得在 一个环节 试;小团队人手少,机器先扫的边际收益有时更大。优先选与现有 MR/CI 同平台的 AI 能力,减少另接一套 SaaS 的整合成本;是否适用,仍须试点验证。
Q3:怎么判断平台是真 AI 还是包装概念?
用第三节五维核对:数据接入、输出闭环、可追溯、人审机制、规则可控。不满足的谨慎评估;满足的宣传项也须用 真实仓库与构建数据 跑 2~4周验证。
Q4:AI 会取代 DevOps 工程师吗?
不会。实践共识是 AI 承担模式化、重复性工作;工程师重心转向规则设计、审批、异常处理与架构决策。关键操作保留人工兜底。
Q5:企业 AI DevOps 平台怎么选?
按 场景 → 数据同源 → 闭环 → 验证 顺序:先定试点环节(第二节),再查数据能否关联(参见 DevOps 盘点文第一节),用第三节五维表逐项核查,最后用第四节指标算 ROI——功能宣传单不可信,试点数据才作数。


相关阅读
更多博客 → 全链路研发管理平台怎么选?一次反查实验,看穿 5 类路径
2026年全链路研发管理平台选型指南。文章从需求到部署的链路视角,梳理禅道+GitFox、GitLab、Azure De...
 AI写代码、AI修Bug,研发管理平台还在等人填工时?
AI写代码后研发管理平台仍靠工时?文章解析工时数据失效的三大原因,提出以评审耗时、返工率等工作流指标替代,并给出技术管理...
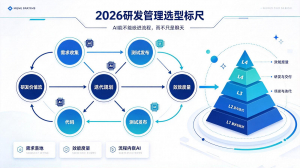 2026 研发管理工具横评:AI 能不能干活,才是分水岭
2026研发管理工具选型指南:AI能否嵌入需求、迭代、交付与效能度量并落回系统成关键。对比禅道、Jira、GitFox、...
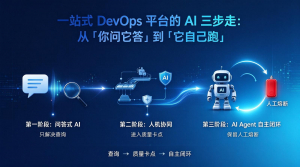 一站式 DevOps 平台的 AI 三步走:从「你问它答」到「它自己跑」
解析一站式DevOps平台的AI三步走:问答式AI、人机协同质量卡点、AI Agent自主闭环。以GitFox AI代码...