


仓库越来越大,代码托管平台要关注哪些性能点?
从克隆拉取、对象打包、存储 IOPS、仓库形状、CI 并发和可观测性六个维度,拆解大仓库给代码托管平台带来的性能压力,并给出可落地的 PoC 验收方法与平台、仓库两侧的治理边界。
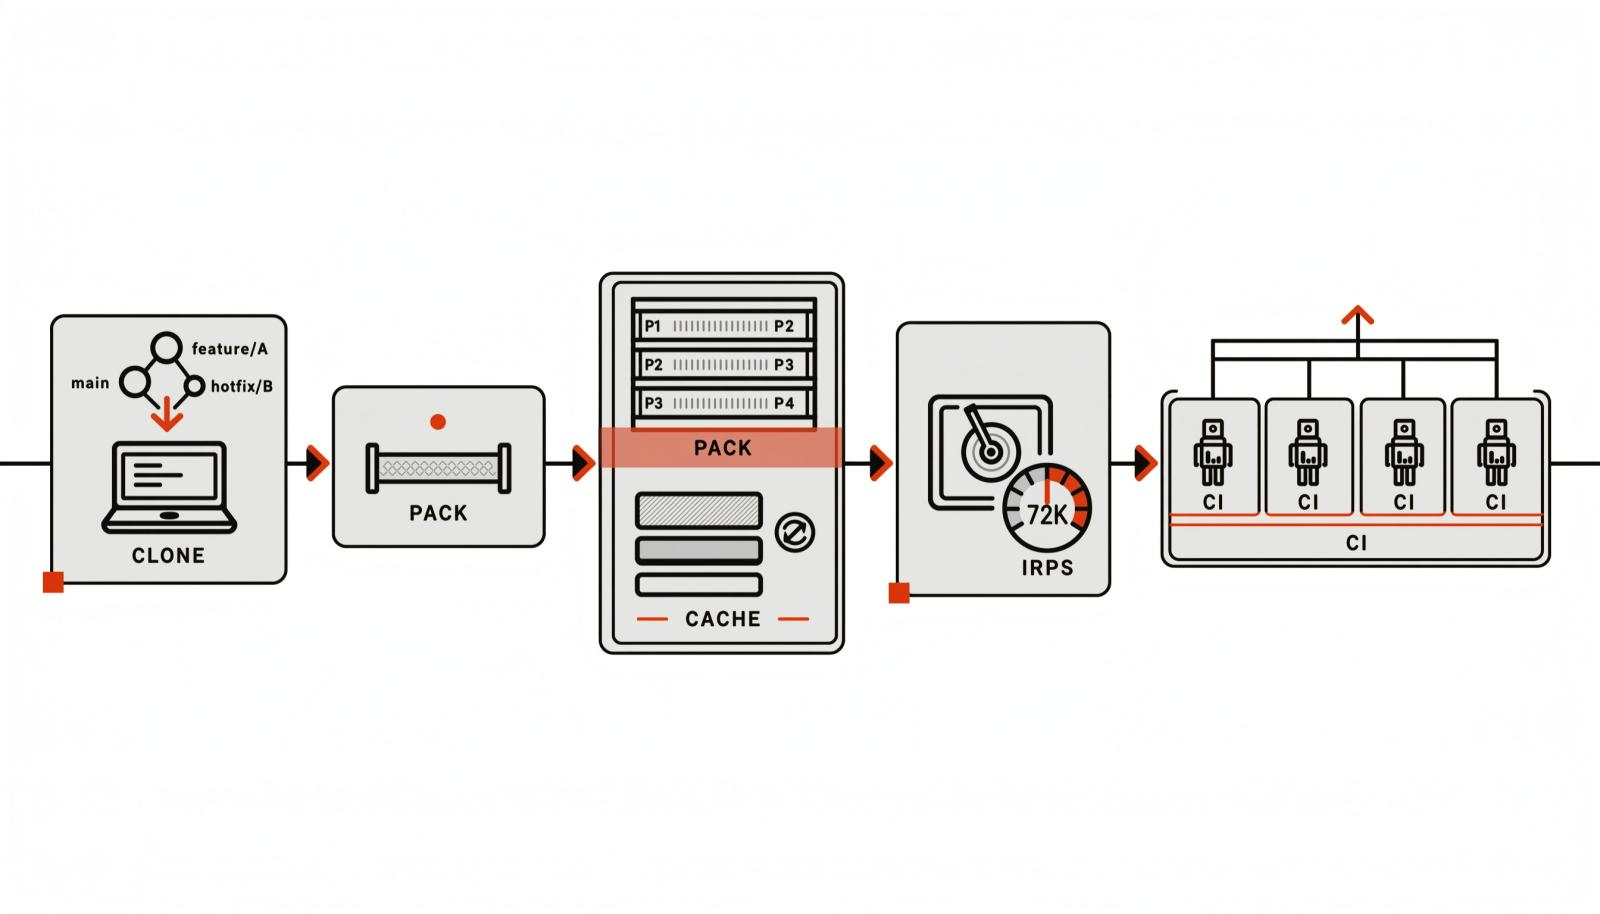
周一早上,开发说 git clone 跑了二十分钟;CI 队列卡在拉代码;仓库首页一直转圈。团队常先加磁盘、升 CPU,但大仓库的瓶颈很少是单点资源不足,而是沿客户端、网络、服务端打包、存储 I/O 和 CI 并发逐级放大。
当仓库从几百 MB 长到几十 GB,代码托管平台要回答的不是“能存多大”,而是真实并发下能否稳定完成克隆、评审和流水线取码。这也是 GitFox 这类一体化 DevOps 底座在私有化场景里必须回答的问题。本文只谈平台侧性能。
一、仓库变大后,为什么变慢了?
1.1 克隆与拉取:打包对象是重活
Git 把对象压缩成 packfile,克隆、拉取、推送都绕不开。截至 2026 年 11 月,GitLab 的 monorepo 性能文档指出,创建 packfile 需要大量 CPU 和内存,git-pack-objects 要分析提交历史、确定发送对象并生成 pack,是 Git 服务里资源消耗最大的操作之一。仓库越大、历史越长、分支越多,这一步越慢。
很多团队只测首次 clone,却忽略日常 fetch 和 CI 并发。只测首次克隆,会漏掉日常瓶颈。 流水线每次在新环境取码,会把服务端 CPU、内存和带宽同时推高。
1.2 引用与目录形状也会拖慢操作
分支和标签都是引用。GitLab 文档提到,引用数量增长会增加查找和遍历成本;克隆时服务器要审查每个引用的对象图,属于 CPU 密集型操作。截至 2026 年 11 月,GitHub 官方仓库限制文档建议:仓库磁盘大小控制在 10 GB 以内,单目录条目不超过 3,000,目录深度不超过 50,分支数不超过 5,000。超过建议值不一定立刻故障,但基本 Git 操作会变慢。
1.3 CI 把单次拉取放大成并发峰值
一个开发者 clone 一次,和五十条流水线同时 clone,是两种负载。GitLab 文档提到,大型 monorepo 常见大量同时克隆和推送,自动化 CI 流量可能让 Git 存储服务过载。定时任务集中在整点启动,就会把偶发问题变成每天一次。
二、代码托管平台要关注的六个性能点
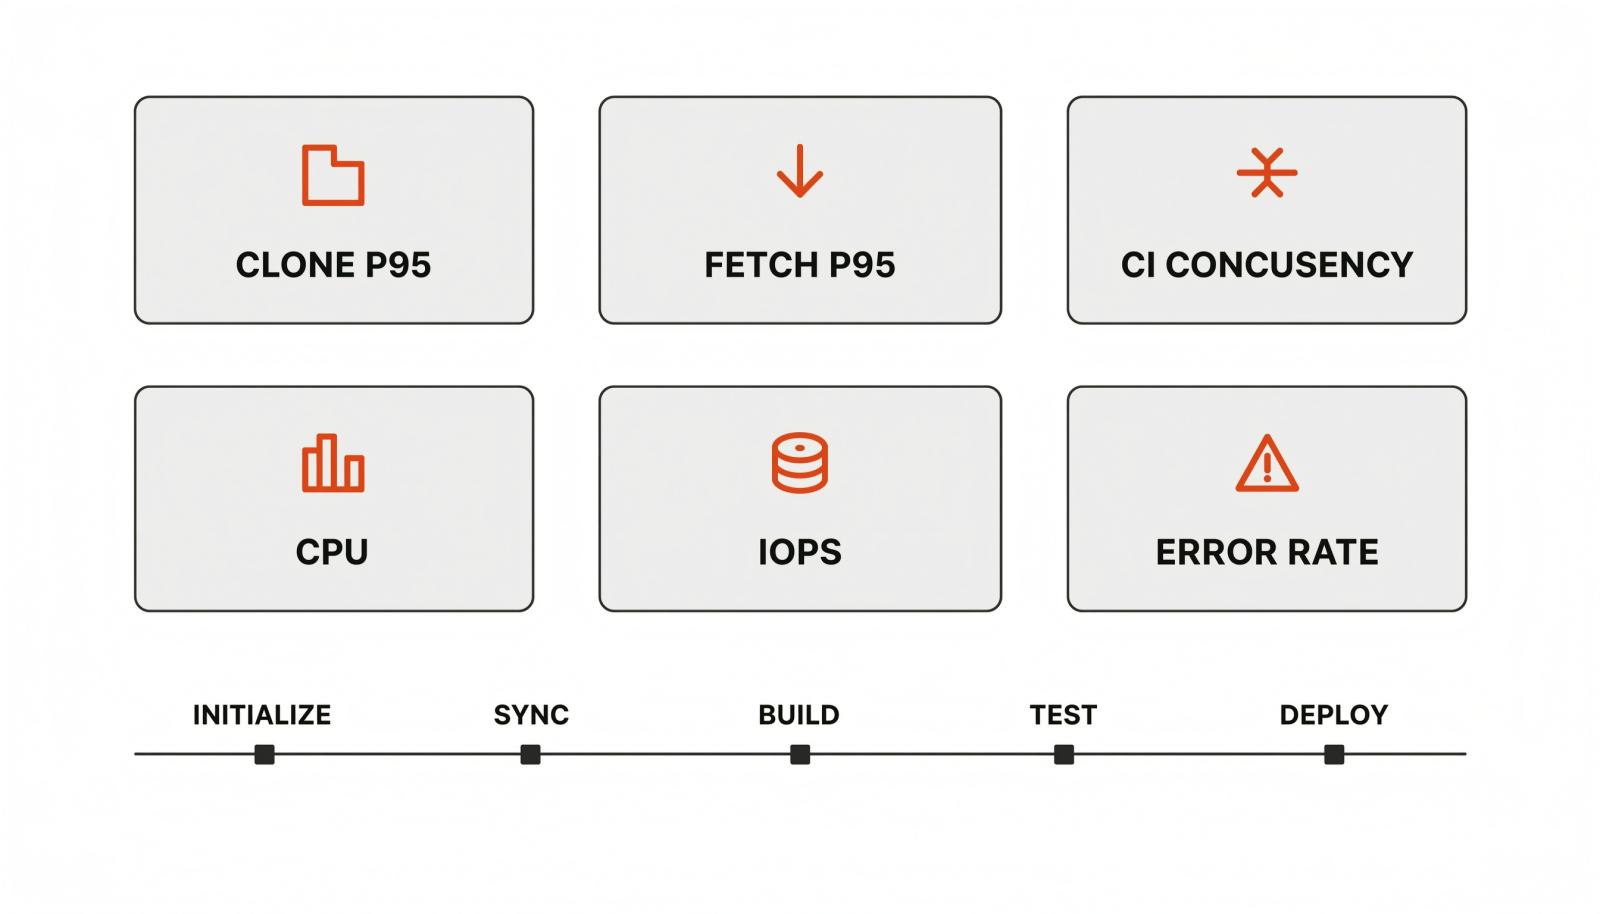
选型和运维至少要看六项,不能只盯磁盘容量。
性能点 | 重点看什么 | 警惕信号 |
|---|---|---|
克隆、拉取、检出时延 | 冷克隆、增量 fetch、checkout 的 P95 | 日常 fetch 超时;CI 取码排队 |
服务端打包与缓存 | pack-objects 的 CPU、内存;缓存命中;并发上限 | 高峰 CPU 打满;同一仓库反复全量打包 |
存储 IOPS 与介质 | 随机读写 IOPS、吞吐、本地盘、容量余量 | 磁盘队列高;Git 与网页同时变慢;使用 NFS |
仓库形状与引用规模 | 体积、目录宽深、分支标签数、大对象占比 | 分支不清理;单目录上万文件;历史有大二进制 |
CI 并发与取码策略 | 并发 clone、浅克隆或部分克隆、fetch 复用、错峰 | 每条流水线全量 clone;定时任务同一分钟启动 |
可观测性与容量余量 | 按仓库拆分的 P95/P99、错误率、CPU、IOPS | 只看整机平均 CPU;没有仓库维度指标;容量长期高位 |
存储和可观测性容易被忽略。 截至 2026 年 11 月,GitLab 的 Gitaly 文档建议使用 SSD 本地盘,因为其并发处理大量小文件、属于 I/O 密集型服务;也不建议 NFS 或云文件系统承载仓库数据。整机平均 CPU 会稀释单个仓库的打包峰值,指标应按仓库拆开。
GitHub 还给过运营参考:每个仓库每秒 15 次 Git 读操作、每分钟 6 次推送。这说明高成本操作要按仓库限流。选型时要问:平台有没有按仓库限流、缓存和配额,超限时排队还是失败。
三、如何选型代码托管平台?
PoC 要用真实仓库、真实并发、固定条件。
用生产仓库镜像或脱敏副本,保留真实历史、分支、标签和目录形状。
固定客户端网络、机器配置、并发数和测试时段。
覆盖冷克隆、增量 fetch、50 路并发 CI 取码、MR diff、网页浏览和备份。
记录客户端 P95、失败率,以及服务端 CPU、内存、IOPS、队列和恢复时间。
把通过标准写进验收,并预留 30% 以上容量余量,不用“最快的一次”当结论。
不要只看平均值:冷克隆看 P95 和失败率,增量 fetch 看是否随提交恶化,并发 CI 看排队和错误率,网页浏览看文件树、搜索和大 diff 是否超时。
四、平台侧与仓库侧,治理要分工
平台负责底座,仓库负责形状。 平台侧要有 SSD 本地盘、足够 IOPS、pack 缓存、并发限制、按仓库监控、内务整理和扩容预案。仓库侧要控制形状:大二进制走 Git LFS,清理长期分支和标签,控制目录宽度,拆分历史大文件,CI 使用浅克隆、部分克隆或复用工作区。
平台不能替一个装满大二进制的仓库买单,仓库治理也不能弥补磁盘 IOPS 不足。GitLab 文档提醒,CI 适合浅克隆和部分克隆,但本地开发不建议浅克隆,因为会拉长推送时间。
五、GitFox 在大仓库场景里的位置
私有化选型时,可以把 GitFox 放进候选。GitFox 是禅道软件 100% 自主研发的一体化 DevOps 底层引擎,也是禅道 DevOps 解决方案唯一内置核心组件,底层代码完全自研,无海外开源内核依赖。
它承载代码托管、分支管控、代码评审、CI/CD 流水线、代码安全扫描、制品仓库和自动化发布;禅道负责项目管理,GitFox 负责研发交付链路,两者是分工关系。
对 50~300 人研发中心、需要私有化或信创适配、希望减少 GitLab、Jenkins 与制品库拼接的团队,这套底座能减少平台切换和对接成本。大仓库性能仍建议用你们自己的仓库跑 PoC,验证克隆、流水线和制品链路。
六、常见问题
仓库多大才算大仓库?
没有统一阈值。GitHub 建议磁盘大小控制在 10 GB 以内,但 5 GB 的高频仓库可能比 15 GB 的低频仓库更慢。要同时看历史深度、分支标签数、目录宽度和并发访问。
大仓库一定要拆仓吗?
不一定。monorepo 可配合平台缓存、CI 浅克隆或部分克隆和任务错峰。若克隆长期超过业务可接受时间、CI 取码成为稳定瓶颈,或权限与发布边界需要隔离,再考虑拆分。
怎么判断是平台问题还是仓库问题?
先看 pack-objects 的 CPU、磁盘 IOPS、队列和错误率;再用 git-sizer 分析仓库形状。只有某个仓库慢,优先查仓库形状;多个仓库同一时段一起慢,优先查平台容量和并发。
结语
仓库变大是研发资产持续积累的结果。代码托管平台的性能评估,应从“能存多少”转向“在真实并发下能否稳定交付”。先量基线,再用真实仓库跑 PoC,最后把容量余量、监控和仓库治理写进日常流程。
需要验证一体化 DevOps 底座时,可以预约 GitFox 演示或试用,用你们自己的仓库跑一遍克隆、评审、流水线和制品链路,再决定是否迁移。


相关阅读
更多博客 → 国产化替代只换工具够吗?流程与数据怎么一起搬
国产化替代若只替换工具,流程、权限和历史数据会在上线后集中暴露。本文把替代拆成工具、流程、数据、权限与审计四层,给出流程...
 2026 DevOps 工具全景图:AI 进场后,这 7 类工具重新洗牌
2026 DevOps工具全景:AI驱动编码审查、CI/CD、IaC、智能化测试、AIOps、DevSecOps与事件响...
 什么是 DevOps 平台?别再把它和 Jenkins 搞混了
别再混淆DevOps平台与Jenkins、CI/CD!本文详解DevOps平台定义、与CI/CD的全维度对比、适用团队及...
 研发管理工具要管哪些环节?从需求到发布逐段拆
从需求、设计、开发、测试、发布五个阶段拆解研发管理工具应覆盖的能力边界,说明每段的核心对象、交付物与常见断点,并给出追溯...