


效能数据造不出来怎么办?埋点、工时与流水线取数对比
效能数据造不出来,往往不是缺看板,而是事件没定义、口径不统一、追溯链断裂。文章按“症状诊断—三种取数边界—分层组合—最小链路—平台验证”拆解埋点、工时与流水线取数的适用场景,给出关联键、校验项和 PoC 检查清单,帮助研发负责人把不可信的报表变成可追溯的交付数据。
月底复盘,看板上的部署频率空着,运维凭发布群回忆;变更前置时间从需求单里估;工时到月底才补填。团队第一反应是再加平台,真正卡住的却是数据从哪来、按什么口径算、出了问题能不能追。
很多团队卡住的地方不在看板,而在数据底座。GitFox 是禅道 DevOps 解决方案唯一内置的底层引擎,100% 自研、无海外开源内核依赖,把代码托管、CI/CD 流水线、制品库与效能看板放在同一套底座里,代码、构建、发布事件天然同源;禅道侧继续管需求、任务与缺陷,两边靠同一条追溯链对齐,少了跨系统拼表这一道工序。
所以,效能数据造不出来时,先别急着上研发效能平台。把问题拆成“没采集、口径不一、不敢用”三类,再判断埋点、工时、流水线各自该补哪一段,通常比换大屏更有效。
一、效能数据造不出来,通常卡在三处
先看症状,不要先猜工具。下面三类情况在研发中心很常见,处理顺序也不同。
| 症状 | 更可能的原因 | 先查什么 |
|---|---|---|
| 看板大面积空白 | 事件没有定义,或发生了但没上报 | 发布、构建、回滚是否留下带时间戳的记录 |
| 两个部门数字对不上 | 分子分母、统计周期或统计对象不一致 | 指标口径、时间窗、服务范围是否写死 |
| 数据都有但没人用 | 指标与改进动作脱节 | 数字能否定位到等待、返工或失败环节 |
先查事件有没有被记录,再查口径是否一致,最后看指标能否指向具体动作。三种修法不同,混在一起就会变成“再买一套平台”。
指标定义可以先借用成熟框架。DORA 官方指南(截至 2026 年 11 月)把软件交付表现拆成五项:吞吐侧看变更前置时间、部署频率、失败部署恢复时间,不稳定侧看变更失败率和部署返工率。它也提醒,把指标当目标、只留一个指标、跨差异很大的应用直接比较,都会让数据失真。先定义指标要回答的问题,再决定采什么数,顺序不能反。
二、埋点、工时、流水线,各自能回答什么问题
三种取数方式经常被放在一张表里比较,但它们本来就不在同一层。流水线记录系统发生了什么,埋点记录人在工具里做了什么,工时记录团队投入了多少。
| 取数方式 | 主要数据 | 擅长回答 | 主要盲区 | 成本与风险 |
|---|---|---|---|---|
| 埋点 | 页面、按钮、操作路径、工具内行为 | 工具是否被用起来、流程卡在哪一步 | 只覆盖埋了点的地方,漏采难以发现 | 需要事件规范、版本管理和前后端配合 |
| 工时 | 任务或项目工时、人员投入 | 投入结构、项目成本、人天估算 | 主观、滞后、颗粒度粗,容易失真 | 填报负担重,口径需要审核 |
| 流水线 | 提交、合并请求、构建、测试、部署、制品、回滚 | 交付周期、部署频率、失败率、恢复时间 | 看不到线下评审、业务价值和真实等待 | 需要打通发布标识和关联键 |
选择顺序可以按问题倒推:问交付快不快、稳不稳,优先用流水线事件;问工具是否被用起来、流程卡在哪一步,用埋点补过程;问项目投入结构和成本,用工时补投入口径。拿工时去证明交付速度,或用页面点击去证明发布质量,都会得到看似有数、实际不能用的结论。
三、三种取数怎么组合,才撑得起研发效能平台
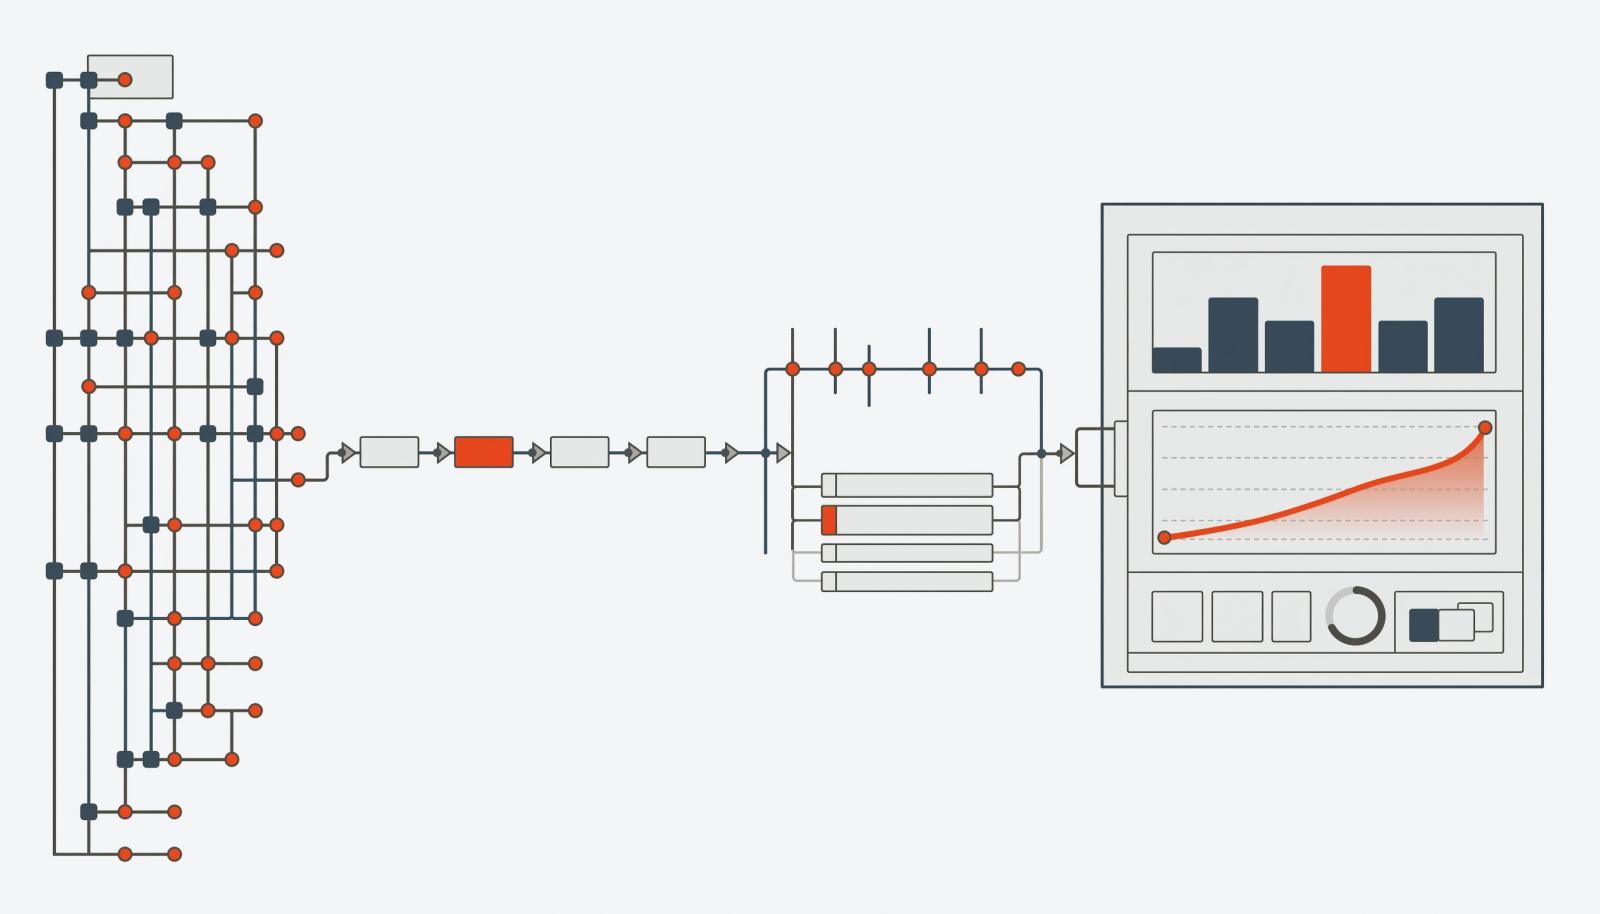
组合不是把三张表拼在一起,而是按“结果—过程—投入”分三层,并给每层定一个主数据源。
- 结果层:以代码提交、合并请求、构建、部署、制品和回滚事件为主,回答交付周期、部署频率、变更失败率和恢复时间。每个指标只认一个主数据源,其他数据用于校验。
- 过程层:用埋点补代码评审等待、环境切换、工具使用和页面路径,回答“时间耗在哪”。过程数据适合做诊断线索,不宜直接替代结果指标。
- 投入层:用工时、需求和项目数据补投入结构与业务口径,回答“这些交付用了多少人、需求从提出到上线经历了哪些环节”。
三层能对上,靠的是关联键。需求 ID、服务 ID、版本号、提交 SHA、环境标识至少要有一种能贯穿;发布记录必须写回流水线,否则变更失败率和恢复时间只能靠人工补。同一指标最好按服务统计,跨应用直接混算,很容易把差异当成效率问题。
研发效能平台的价值,不是把更多报表放到一个页面,而是让同一个事件在需求、代码、构建、制品、发布之间可追溯。 追溯断了,看板越漂亮,争论越多。
四、先跑一条最小链路,再谈大屏
不要从全公司指标开始。选一个服务、一条真实发布链路,用两周跑通下面五步。
- 选问题:先回答“从提交到生产可用要多久”,或“最近十次发布有多少次回滚”。一次只选一个。
- 定事件:把提交、合并、构建开始与结束、部署开始与结束、故障、回滚写成事件字典,字段至少包含时间、服务、环境、版本和触发方。
- 设关联键:用需求 ID 串需求与提交,用服务 ID 串发布与监控,用版本号串制品与发布记录。
- 做校验:查完整性,核心服务是否每天都有记录;查一致性,同一指标能否和发布单、监控记录对上;查可解释性,异常能否追到具体阶段。
- 跑基线:先看两周趋势,再决定是否扩展到更多团队。先看趋势和瓶颈,不急着做跨团队排名。
变更失败率和服务恢复时间还要接告警、事故和恢复记录。具体怎么把监控事件化、再与代码和发布记录关联,可以参考监控数据怎么接进研发效能度量,不用从零设计一套事件模型。
五、研发效能平台选型,先看数据底座而不是看板数量
选型时容易被大屏和指标数量吸引,但决定数据能不能造出来的,是底座有没有原生事件和追溯关系。可以用下面四项做 PoC 检查。
- 事件是否原生:代码、流水线、制品、发布是否在同一套对象模型里,还是每个指标都要单独写接口、做 ETL。
- 口径是否可解释:指标定义、时间窗、分子分母能否在页面查到,能否按服务、团队和时间切片。
- 追溯是否闭环:需求、缺陷、提交、构建、制品、发布能否互查,回滚能否对应到具体版本。
- 运维是否可控:私有化部署、权限隔离、审计日志和信创适配是否满足当前环境,50~300 人研发中心的运维投入是否可承受。
GitFox 的效能看板和流水线、制品库、代码托管在同一底座里,发布事件和版本记录不需要跨三套系统拼接;禅道侧继续承接需求、任务和缺陷,适合想把研发管理与交付链路一起打通的中大型研发中心。如果团队已经用 Jenkins 承担流水线执行,也可以保留执行层,把构建和发布事件接回统一底座,关键是别让看板成为第五套系统。
几个绕不开的问题
工时数据能不能直接用来考核研发效能?
不建议。工时是投入口径,受填报习惯和颗粒度影响,更适合看投入结构、项目成本和人天估算。一旦直接用于个人排名,填报就会失真,数据越用越不可信。
埋点会不会增加前端负担?
会,但可控。只埋关键动作,统一字段和上报时机,做版本管理;不要为了看板把每个点击都上报。埋点是诊断工具,不是全量监控。
只有 Jenkins 和 GitLab,能取到这些数据吗?
能取到一部分,但需要把构建、部署、回滚事件标准化,落到统一事件表,再补关联键。工具能提供原始记录,不等于自动产出可解释的指标。
数据造不出来,是不是该换平台?
先诊断。如果事件没定义、口径不统一、发布记录缺失,换平台也可能重演;如果现有平台无法提供基础事件、追溯链路经常断,才进入换平台的评估。
结语
效能数据造不出来,多数时候不是缺一个更炫的看板,而是缺一条从事件定义到指标验收的链路。先用流水线事件把交付结果做可信,再用埋点解释过程,用工时补投入,最后才谈平台和大屏。一条能对上账的链路,比十张填不满的报表更有用。
如果正在做 PoC,可以拿最近十次真实发布做一次反查:每次发布能否找到对应的提交、制品、部署记录和回滚记录。这条链路跑通,再讨论研发效能平台的范围和投入,判断会踏实很多。需要先看 GitFox 的数据底座和部署方式,可以从DevOps 版介绍开始。
参考资料:DORA. DORA's software delivery performance metrics.


相关阅读
更多博客 → AI代码扫描爆火,代码安全扫描工具该盯增量还是全量?
AI代码安全扫描该选增量还是全量?本文解析两者差异与AI工具能力,提出日常增量、定期全量、人工复核的分层防御策略,并强调...
 制造业研发周期长,研发进度和变更怎么管住?
制造业研发周期长,延期往往不是画图慢,而是计划层级不清、阶段出口没有决策、变更影响评估漏项。文章给出三层计划、阶段门、变...
 互联网多产品线并行,研发管理工具怎么分层?
多产品线并行时,工具分层的关键不是减少系统数量,而是让需求、代码、制品、发布记录和指标各有唯一主系统。文章给出产品线组合...
 双周迭代跑不顺,敏捷研发管理平台能补哪些环节?
双周迭代跑不顺,往往不是周期太短,而是需求、开发、测试、制品与发布之间存在等待和断点。本文按“症状—诊断—能力匹配—小范...