


二进制大文件怎么管?一文搞懂嵌入式仓库的体积难题
嵌入式仓库被固件包、SDK 和预编译库撑大后,克隆、CI 与协作都会变慢。文章按“能否重建、是否必须与代码同版本、是否多项目共享”把二进制文件分流到 Git LFS、制品库和独立仓库,并给出 LFS 的适用边界、历史瘦身的可回滚步骤与日常体积门禁。
固件包、SDK、预编译库、测试数据——嵌入式项目里真正占地方的,往往不是那几十万行 C 代码,而是这些跟着硬件版本反复提交的二进制文件。仓库从几百 MB 长到几个 GB 后,克隆变慢、CI 磁盘告警、切分支卡顿,问题会一起出现。
别急着删文件,先分清哪些该留在 Git 里。 按“能否重建、是否必须与代码同版本、体积多大”分流:该进 Git LFS 的进 LFS,该进制品库的进制品库,第三方 SDK 用独立仓库固定版本。GitFox 把代码托管、流水线和制品库放在同一套权限体系里,减少跨系统找包、手工对版本号的动作。这也是嵌入式开发代码管理工具要先定的事。
一、嵌入式仓库被撑大,通常不是代码的问题
先看症状:完整克隆越来越慢、CI 每次重新拉大量数据、备份从分钟级变成小时级、切分支明显卡顿。它们通常指向同一类对象:二进制文件。
Git 擅长管理文本差异,对固件 .bin、.hex、.elf、静态库、压缩包、音视频和点云数据的效果有限。每次提交新版本,仓库就可能多存一份接近完整大小的数据,历史版本还不会自动消失。常见的体积大户包括:
- 固件烧录包和量产镜像;
- BSP、SDK、预编译库;
- 工具链安装包、仿真器和测试数据。
Google Cloud 的 DORA 团队在版本控制能力说明中建议,大型虚拟机镜像、ISO、编译产物这类对象放入制品仓库或对象存储,而不是长期跟着源码仓库走。这个判断同样适用于嵌入式项目。
二、三类二进制大文件,先找到各自的归处
判断归处,先回答三个问题:
- 能不能重新构建? 能由流水线稳定产出的烧录包、安装包,不该进源码库。
- 是否必须和某次提交严格对应? 需要按 commit 回溯的配置表、校准数据,适合 Git LFS。
- 是否多项目共享、体积又大? 第三方 SDK、工具链适合独立仓库加子模块,或放进制品库。
下面这张表可以直接对照。
| 类型 | 典型文件 | 建议归处 | 追溯方式 |
|---|---|---|---|
| 与代码强关联的小体积二进制 | 寄存器配置、校准表、测试向量 | Git LFS | 指针随 commit 入库 |
| 可重建的构建产物 | .bin、.hex、.elf、烧录包 |
制品库 | 关联 commit 与构建号 |
| 第三方 SDK、工具链 | BSP、预编译库、仿真器 | 独立仓库加子模块或制品库 | 固定版本号与校验和 |
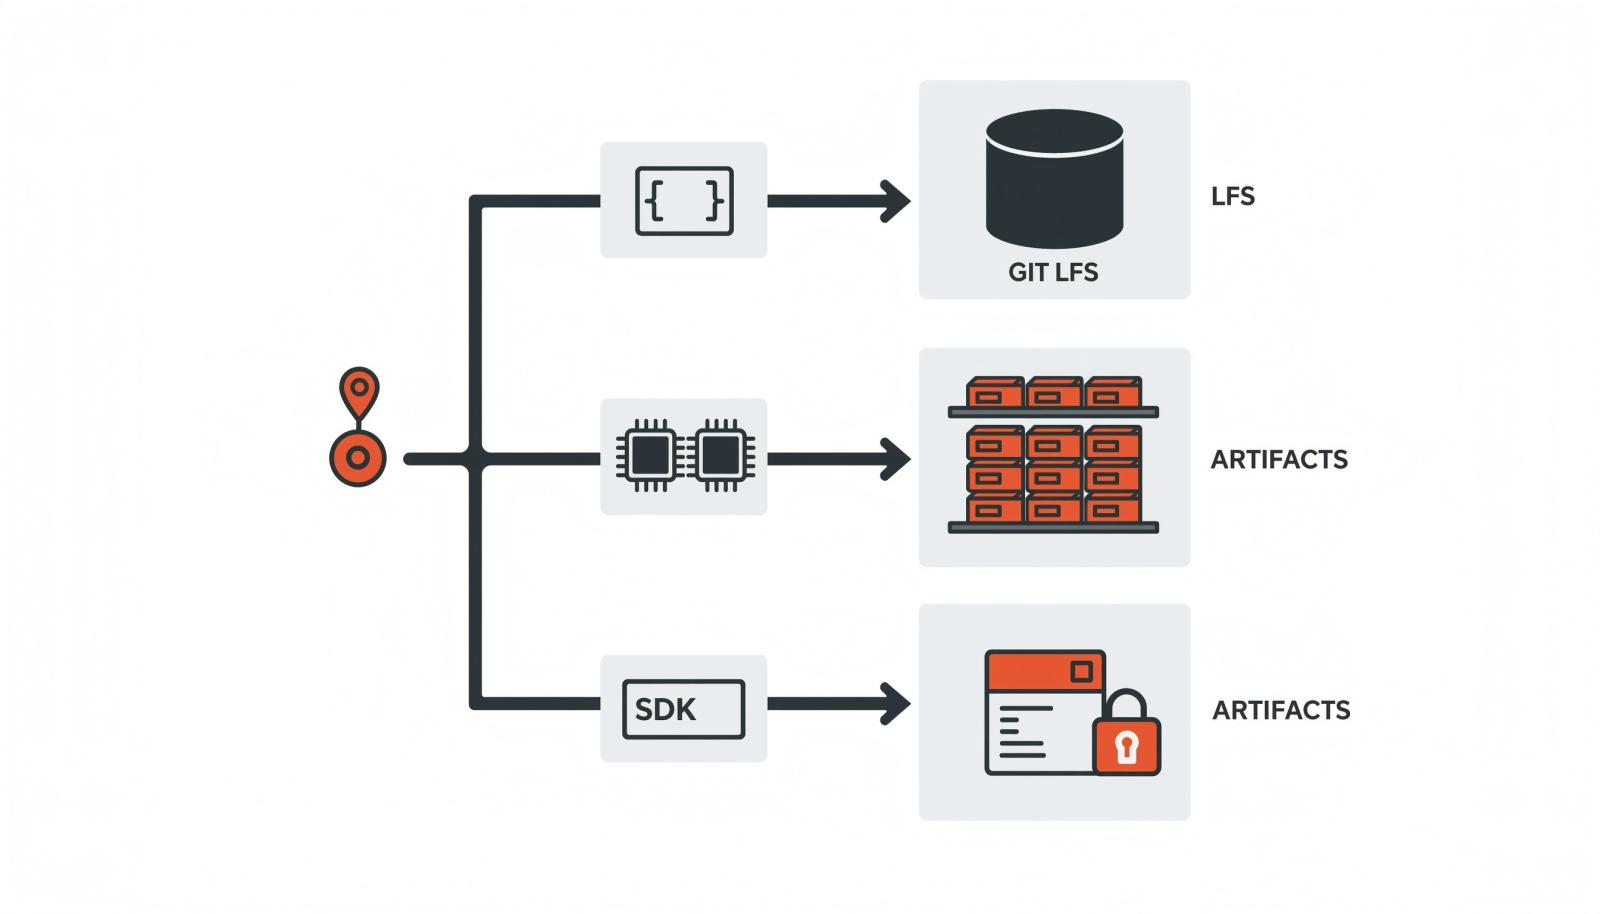
分流后,源码仓库只保留“读得懂、改得动、值得评审”的内容,构建产物进制品库,外部依赖固定版本。源码仓库不必承担大文件存储,制品也能保留版本追溯。
三、二进制大文件交给 Git LFS,也要守住边界
Git LFS 的思路很直接:仓库保存文本指针,真实文件放到独立存储;克隆时先拿指针,需要时再拉内容。官方文档把它概括为“大文件替换为文本指针,文件内容存放在远程服务器”,并强调它能减少克隆和拉取的数据量。
启用通常只需三步:
git lfs install
git lfs track "*.bin" "*.hex" "*.a"
git add .gitattributes
关键限制有三个:
-
只对后续提交生效。 历史文件不会因为新增
.gitattributes自动转入 LFS,需要用git lfs migrate或重写历史。 - LFS 不会合并历史版本。 同一个文件每提交一次,LFS 就多一份对象,高频大文件会把压力转移到存储。
- CI 要能取到 LFS 对象。 流水线需安装客户端并拉取,否则构建读到的是指针文件。
LFS 适合“体积中等、变更不频繁、必须跟代码同版本”的文件;每次构建都重新生成的烧录包,放制品库更合适。
四、嵌入式开发代码管理工具怎么把代码、构建和制品接起来
仓库、流水线和制品库各自为政时,团队往往要在代码平台找 commit,去流水线找构建号,再到另一套系统下载安装包,最后手工填发布记录。环节一多,错版就很难避免。
GitFox 是禅道软件 100% 自主研发的一体化 DevOps 底层引擎,也是禅道 DevOps 解决方案唯一内置核心组件,底层代码完全自研,无海外开源内核依赖。它承担代码托管、分支权限、代码评审、流水线、代码扫描、制品库与发布;禅道负责需求、任务、Bug 等项目管理层,两者通过原生关联把需求、提交、构建和制品串起来。
对 50~300 人的研发中心、制造与硬件团队,以及需要私有化和信创适配的组织,这种一体化减少了跨系统对版本号的成本;如果只需要一个轻量 Git 服务,专用代码托管工具也能满足,边界在于是否要把权限、审计、制品和发布追溯放在一起管。
五、已有仓库已经很大,怎么安全瘦身
历史清理不可逆,顺序比命令更重要。先量体积,再决定是否重写。
第一步,做只读备份。 用 git clone --mirror 镜像到独立磁盘,并保留原仓库只读副本。没有可恢复的备份,不要开始。
第二步,定位大对象。 git count-objects -vH 看总大小和松散对象,git-sizer 指出大 blob、大目录和大提交。先确认谁在占空间。
第三步,选择处理方式。 只影响未来的,加 .gitattributes 并培训规范;历史已经很大的,用 git lfs migrate import 迁移指定类型,或用 git filter-repo 移除构建产物。两条路都会改写提交哈希。
第四步,清理并强制推送。 本机执行 git reflog expire --expire=now --all 和 git gc --prune=now,再强制推送;服务端也要完成垃圾回收。旧克隆不能直接 pull 到新历史,建议重新克隆。
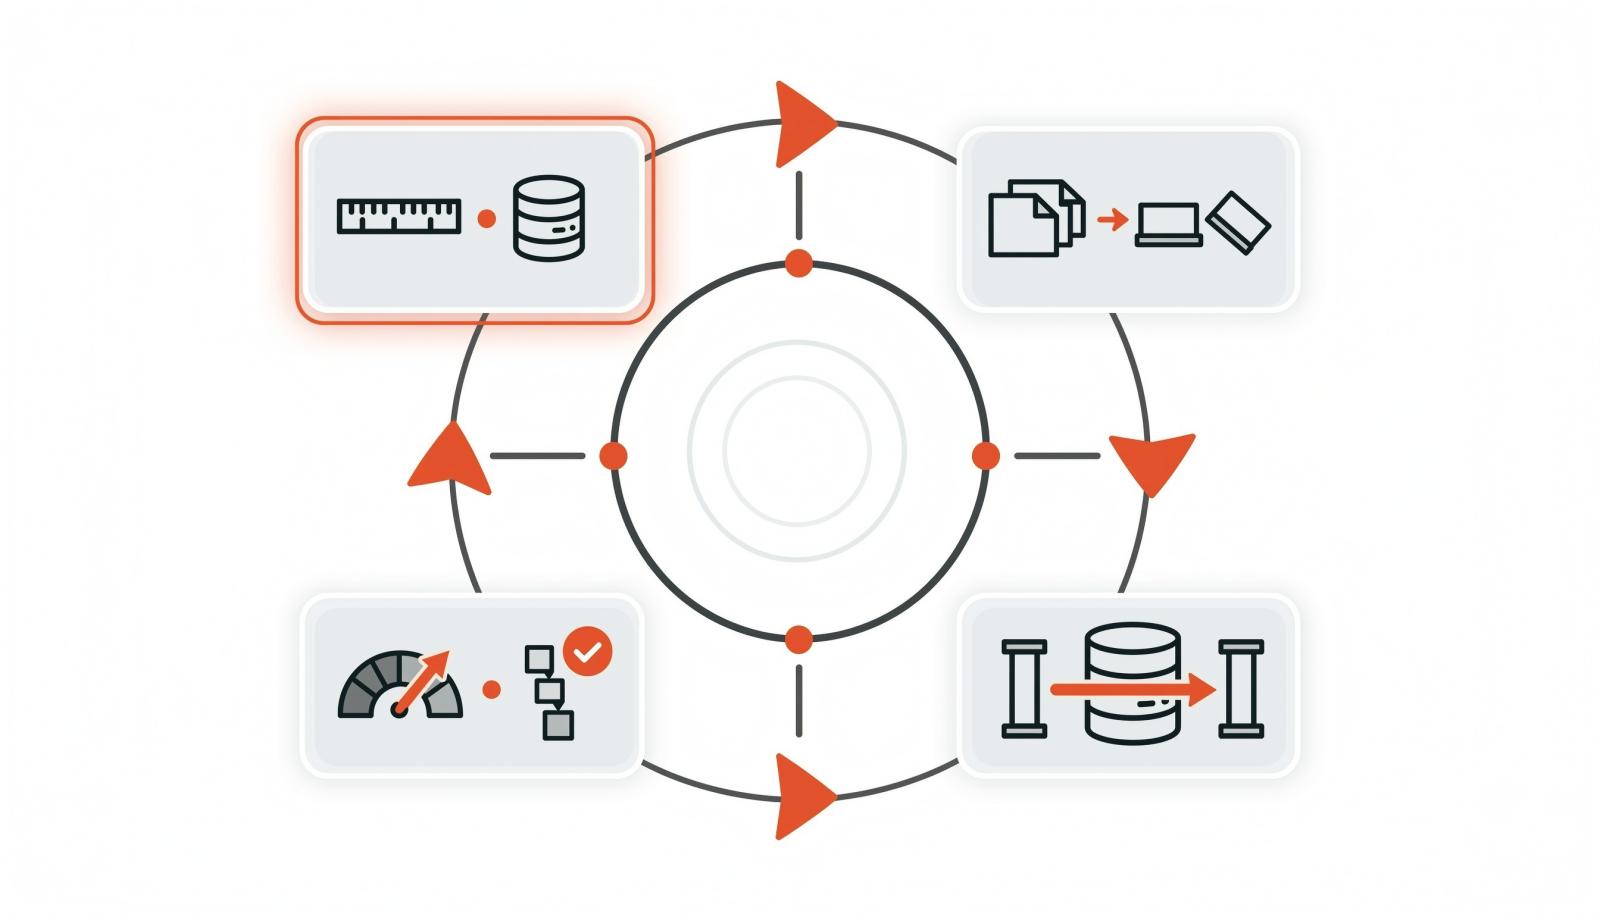
重写前通知所有开发者,并处理开放分支、合并请求、CI 缓存、签名提交和子模块引用。验证标准不是“仓库变小了”,而是克隆时间下降、流水线能取到依赖、历史仍可追溯、回滚备份可用。 确认前不要删除镜像备份。
六、把二进制大文件的体积管住,靠三条日常规则
一次瘦身只解决存量,防止反弹靠日常门禁:
- 提交前拦住大文件。 在本地钩子或 CI 设阈值,例如超过 5 MB 提醒、超过 20 MB 拦截,并要求说明归处。
-
把
.gitattributes当代码维护。 LFS 追踪规则进入评审,新增文件类型时同步更新。 - 给制品和 LFS 定保留策略。 发布版本长期保留,临时构建按周期清理;每月查看仓库体积、LFS 存储和前 20 个大对象。
门禁如果只拦住 Git,文件仍会从制品库侧继续堆积,所以规则要覆盖代码、构建和制品三段。
七、二进制大文件,几个容易踩错的地方
Git LFS 能直接让已有仓库变小吗?
不能。LFS 只改变后续提交的存储方式,历史大文件仍在。要缩小存量,需要用 git lfs migrate 或 git filter-repo 重写历史,并承担提交哈希变化的协作成本。
固件烧录包该进 Git 还是制品库?
优先制品库。烧录包通常可由流水线重建,体积又不小,放进源码库会让每次构建都携带完整历史。只有必须与某次提交严格绑定、体积可控的配置类二进制,才考虑 LFS。
清理历史后,为什么仓库还是很大?
常见原因是旧克隆、服务端悬空对象、LFS 对象或备份还没清理。重写只改了引用,对象要等垃圾回收;其他克隆再次推送旧历史,也会把对象带回来。
八、结语
对嵌入式开发代码管理工具来说,二进制大文件管理不是清一次仓库就结束,而是把“什么该进 Git、什么该进制品库、什么该定期清”变成团队默认规则。可以用一个真实仓库做小范围验证:先量体积,再迁移一类文件,最后对比克隆时间、CI 磁盘占用和构建成功率。需要把代码、流水线和制品放在一套权限里验证,可以预约 GitFox 演示,用示例流水线跑通提交、构建、制品入库和回查。


相关阅读
更多博客 → 一文读懂流水线跑得慢难题:构建、测试还是环境?
从排队、构建、测试、环境四段拆解流水线变慢的耗时构成,给出缓存命中、用例分层、Runner 排队与镜像拉取的判断信号,附...
 DevSecOps 平台怎么选?先看漏洞发现后谁来修
从漏洞发现后的责任断点、修复证据、PoC 验证与 TCO 边界出发,说明 DevSecOps 平台选型为什么要先看修复闭...
 互联网团队要不要自研研发管理工具?维护成本有多少?
互联网团队自研研发管理工具前,需要先算清长期维护账。文章拆解自研与采购的成本项,给出可填数的年度成本公式与三年对比方法,...
 双周迭代跑不顺,敏捷研发管理平台能补哪些环节?
双周迭代跑不顺,往往不是周期太短,而是需求、开发、测试、制品与发布之间存在等待和断点。本文按“症状—诊断—能力匹配—小范...