


一文读懂流水线跑得慢难题:构建、测试还是环境?
从排队、构建、测试、环境四段拆解流水线变慢的耗时构成,给出缓存命中、用例分层、Runner 排队与镜像拉取的判断信号,附优先级清单和回滚验证方法,说明如何用度量数据把一次优化变成持续改进。
周五下午合并一个前端小改动,流水线跑了四十多分钟。翻日志看不出卡在哪,问运维说机器在排队,问开发说测试本来就慢。三句话各有道理,慢的原因也就一直没人查清。
在 50 到 300 人的研发中心里,这很常见:提交量涨了,环境多了,流水线从十几分钟拖到半小时,大家开始习惯“等它跑完”。先别急着换 CI/CD 工具。多数变慢不是工具不行,而是构建、测试、环境三段里,某一段的等待被反复放大。GitFox 把代码托管、流水线、制品库和发布放在同一平台,一段变慢时,代码、任务和产物能在同一处对上,少一次跨系统拼图。
一、一条流水线的时间到底花在哪
先量后改。流水线的慢分两种:执行慢,是编译和跑用例本身耗时;等待慢,是排队、等测试环境、等镜像拉完。混在一起看,得不出结论。
把最近一周的记录导出,按排队、构建、测试、制品与发布、失败重跑拆开,成功和失败分开统计。多数团队拆完会发现,最耗时的和原先猜测的不一样。
DORA 的交付指标里,变更前置时间统计从代码提交到投入生产的时间,流水线里的每次排队都计在内。所以“机器不够”常是表象,真正的成本是时间被切成很多段,每段都在等。
阶段 | 常见耗时构成 | 先看的信号 |
|---|---|---|
构建 | 拉依赖、编译、打镜像 | 依赖下载占比、缓存命中率、同 commit 重跑波动 |
测试 | 单元、接口、端到端、等测试环境 | 用例耗时前几名、重跑通过率、分片是否生效 |
环境 | Runner 排队、拉镜像、资源不足 | queued 与 running 是否分开计时、节点负载 |
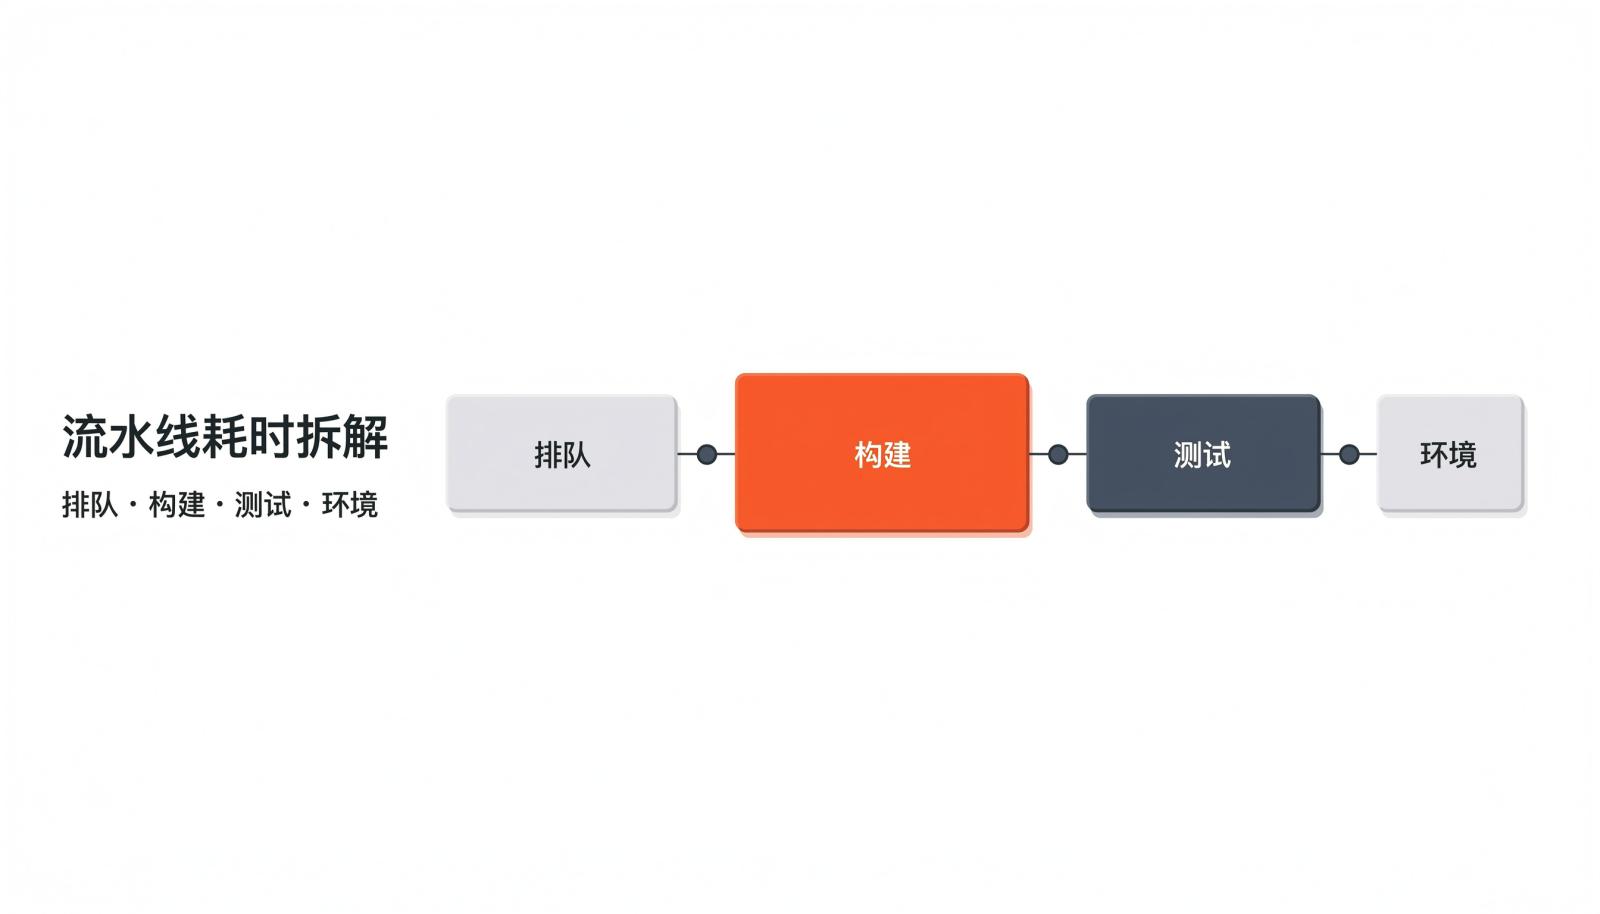
先看占比,再看波动:占比决定修哪段,波动决定是配置还是资源问题。
二、构建慢?先看 CI/CD 工具的缓存和并行
构建段的慢,多数落在两件事:重复做做过的事,和能并行的事在排队。
缓存 key 跟着 commit 走,每次提交都是新 key,永远命中不了;应当跟着依赖锁定文件或镜像版本走。
缓存路径没覆盖大头,依赖仍从公网拉;构建机没有私有制品库或镜像代理,跨网下载就吃掉大半时间。
缓存和制品混用。缓存是可丢弃的加速层,制品是要归档的交付物,清理策略一改就回到全量。
并行更直接:stage 默认串行,stage 内的 job 又没声明依赖,所有任务陪最慢的一起等。把互不依赖的模块拆成并行 job,用依赖声明跳过整段等待,总时长才接近最长分支,而不是各段相加。
改完看三个信号:依赖下载到秒级、同一 commit 二次构建更快、并行后总时长接近最慢分支。
三、测试慢,多半不是用例太多
“测试太多”是最容易接受的解释,也最容易掩盖问题。把大量端到端用例塞进每个合并请求,慢是必然的,但根因通常是用例没分层,测试之间还在抢同一套数据。
一个能落地的分层:
提交前只跑静态检查和单元测试,几分钟内给反馈。
合并请求跑接口测试和关键路径用例,用质量门禁卡住不合格的合并。
全量回归和端到端放到夜间或发布前,允许跑得久。
分片并行能继续压缩时间,前提是数据隔离。多个分片连同一个测试库,会出现偶发失败,团队只好加重跑,时间又被拉回去;每个分片用独立 schema 或临时容器,失败才可信。
还要盯重跑率。重跑后通过的比例高,说明用例不稳定,不是流水线快慢的问题;这类用例不清理,时长优化几次都会反弹。成功信号是合并请求反馈稳定在十分钟量级,夜间全量照常跑。
四、环境慢:排队、拉镜像、资源不够,信号不一样
环境段最容易被误判成“机器不行”,三种情况的处理方式其实不同。
Runner 排队。并发不够、标签匹配不到节点、一个大 job 占住执行器,都会显示为 queued。排队和执行分开计时,才知道该扩容还是拆任务。
镜像拉取。基础镜像几个 GB,换节点就重拉;固定基础镜像、分层构建、就近缓存,通常比加机器见效快。
资源不足。内存不够触发 OOM、磁盘写满、节点超卖,表现是用时忽长忽短、偶发失败。给任务设资源请求与上限,比无限加并发稳。
还有环境不一致。本地能过、流水线挂,排查时间最后也记成“流水线慢”。把运行环境做成固定镜像、就绪检查前移,能减少这类返工。
成功信号是排队占比降到可忽略、拉镜像时间稳定、失败类型从超时转为断言失败。超时变少,才说明环境不再是瓶颈。
五、CI/CD 工具的度量能力,决定优化能不能持续
一次优化靠人盯,持续优化靠数据。固定记录五项:分段耗时、排队时长、缓存命中率、重跑率、失败类型。按周看趋势,按项目看差异。
这也是 CI/CD 工具拉开差距的地方。GitFox 是禅道 DevOps 唯一内置的核心组件,底层为自研引擎,不依赖海外开源内核;代码托管、流水线、效能度量看板在同一套底座里,每次构建的分段数据能直接对上。与禅道的分工也清楚:需求、任务、缺陷在禅道里跟踪,代码、流水线、制品在 GitFox 内完成,通过提交与任务关联。私有化、信创和内网离线环境,一体部署在权限与边界上更好交代。
速度不是唯一目标。Google Cloud 的 DORA 在《2025 年 AI 辅助软件开发状态报告》里把 AI 描述为放大器:采用度提高的同时,交付吞吐上升,稳定性却可能下降。变更失败率和返工率一起上升,这次提速只是把问题推到后面。
六、按信号排优先级,改完还要验证
按“耗时占比高、改动小、可回滚”排序,先做这几项:
依赖下载占构建时间一半以上,先接私有制品库或镜像代理,再调缓存 key。
同一 commit 重跑耗时波动超过三成,先查节点资源和排队,别急着改脚本。
测试耗时集中在少数用例,先拆这几条,不必重构整个框架。
排队时长长期高于执行时长,先拆大 job、加执行器标签,再扩容。
重跑通过率偏高,先隔离测试数据,再谈并行分片。
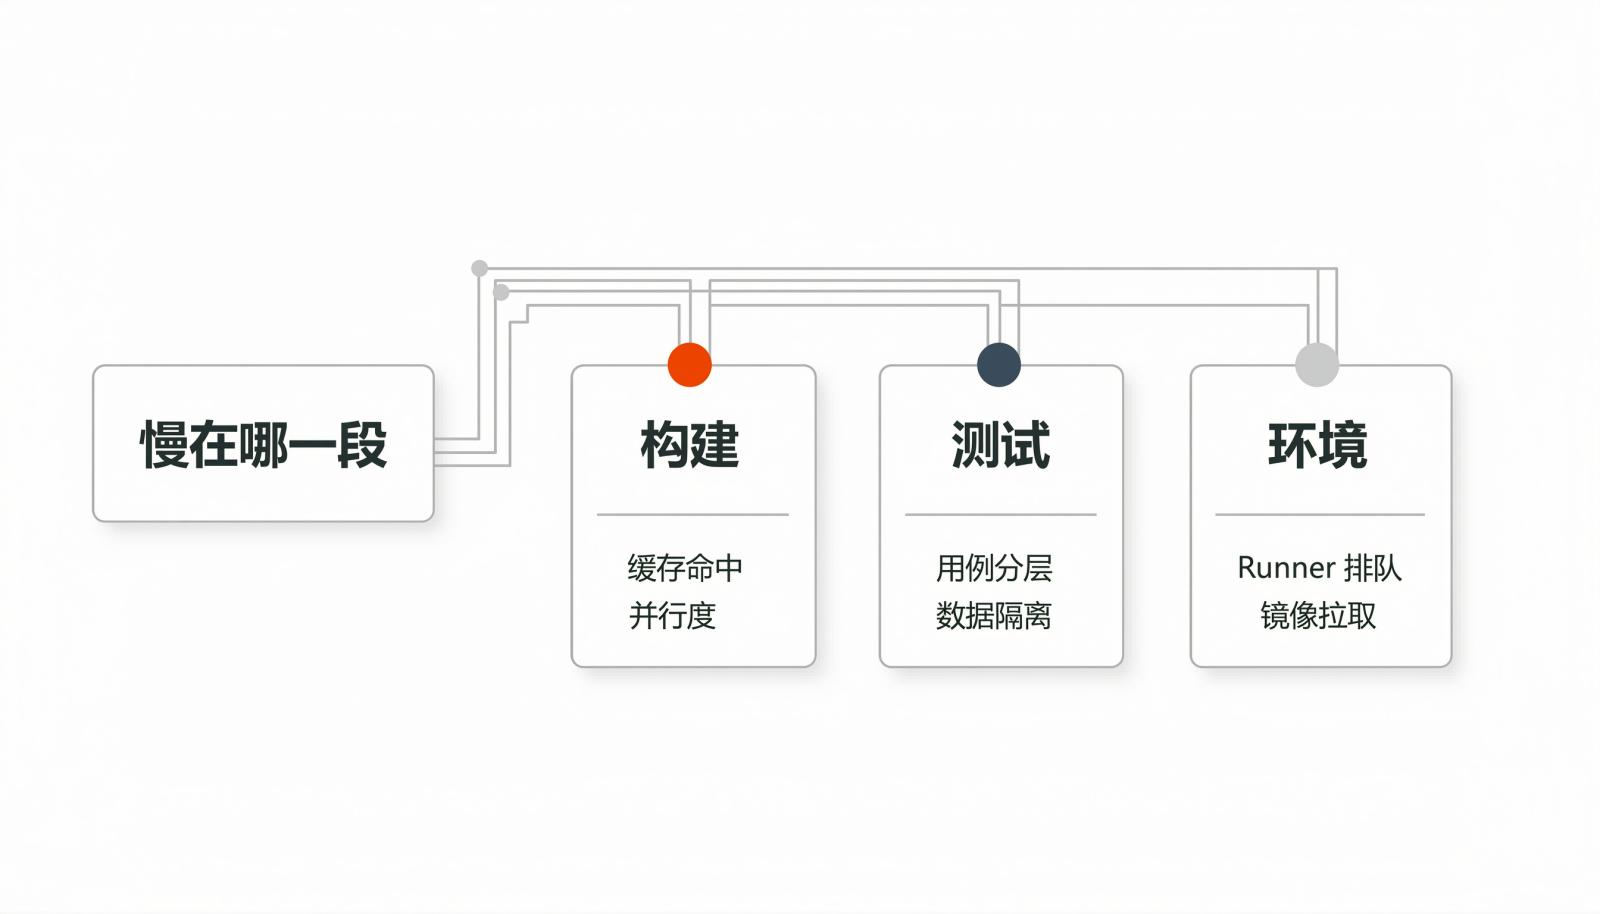
验证看四周趋势:分段耗时的中位数和 P95、构建成功率、变更失败率、重跑率。中位数降了 P95 没降,长尾还在;成功率降了,说明提速牺牲了稳定。
缓存配置、并行度、资源配额保留上一版,先在一条业务线灰度一周。出现缓存污染或资源争抢,直接回退。流水线优化的终点不是“跑得快”,而是每次提交都能在可预期的时间里得到可信的反馈。
七、常见问题
1. 加了缓存还是慢,通常哪里没配好?先看命中率。key 跟着 commit 变、缓存路径没覆盖依赖目录、执行器之间不共享缓存,都会让缓存形同虚设。
2. 并行数是不是越多越好?不是。并行受 CPU、内存、数据库连接和授权数量限制,超过瓶颈后时长不再下降,失败率反而上升。
3. 应该先优化构建还是测试?看分段占比,先动占比最高、改动可回滚的那段。两边接近时,先做缓存和用例分层,风险最低。
4. 流水线快多少才算有效?中位数和 P95 同时下降,构建成功率与变更失败率稳定。只快一次不算,连续四周趋势向下才算。
八、结语
流水线变慢很少是单点故障,也很少能靠换一个 CI/CD 工具解决。把时间拆成排队、构建、测试、环境几段,用信号定位,按风险和收益排序,通常不用换掉整套工具就能拿回大半时间。想把分段耗时先量出来,可以用 GitFox 的免费试用环境跑一遍现有项目,或预约一次演示,对着自己的流水线看数据。


相关阅读
更多博客 → 私有化部署 DevOps 软件怎么选?先看能不能离线跑
从离线可用性切入,拆解私有化部署 DevOps 软件在安装介质、身份权限、流水线、制品发布、安全审计和升级运维六层上的验...
 私有化研发协同系统要和哪些内网系统打通?
私有化研发协同系统落地时,账号、消息、构建、制品与审计往往分散在内网各系统。文章按依赖关系拆解五类必须或建议对接的系统,...
 GitOps 是什么?和 CI/CD 流水线怎么分工?
GitOps 以 Git 作为期望状态的单一事实来源,通过声明式配置和持续协调管理部署;CI/CD 流水线负责构建、测试...
 流水线管理软件怎么选?编排几种发布方式是关键
从发布方式编排切入,拆解蓝绿、灰度、滚动、分批四类发布策略与多环境执行、审批回滚、制品追溯等选型要点,并给出可执行的发布...