构建与依赖管理工具解决什么问题?缓存、私服与版本
从构建慢、依赖缺失、回滚找不到包等常见症状切入,解释构建与依赖管理工具在缓存复用、私服代理和版本锁定上的作用,并给出可落地的检查项与验证指标。
同一份代码,在开发机上能跑,到了 CI 却报依赖缺失;同一条流水线,换台构建节点,依赖又从头下载;线上出问题想回滚,却发现找不到当时那个安装包。这些现象看着分散,根子往往在同一处:依赖怎么取、构建怎么复用、产物怎么存、版本怎么定,没有被当成一条链路来管。
构建与依赖管理工具处理的正是这段过程:把源码编译成可交付产物,同时把依赖获取、版本解析、缓存复用和制品留存固定成可重复的步骤。GitFox 是禅道 DevOps 内置的自研一体化引擎,承接从代码到制品的交付段,底层代码完全自研,不依赖海外开源内核;它把代码托管、流水线、制品库放在同一套权限与审计下,适合 50~300 人研发中心和中大型组织做私有化交付,减少 GitLab、Jenkins 与第三方制品库来回拼接的维护成本。
一、构建与依赖管理工具到底解决什么问题
构建工具负责把源码变成产物,包括编译、测试和打包;依赖管理负责声明、获取、解析和锁定项目用到的外部库。两者经常出现在同一个工具里,但解决的问题并不相同。Maven 官方文档把依赖管理描述为定义、创建和维护可重复构建的核心能力,这个说法点到了要害:工具管的不是某一次构建能不能过,而是下一次、换一台机器还能不能得到同样的结果。
常见症状 | 工具层的动作 | 判断依据 |
|---|---|---|
本地能跑,CI 报依赖缺失 | 统一依赖解析与版本锁定 | 同一提交在本地与 CI 的依赖树一致 |
项目变大后构建越来越慢 | 复用未变化任务的输出 | 输入没变时不再重复执行 |
内网访问不了公网仓库 | 私服代理与内部包托管 | 构建只依赖内网地址 |
回滚时找不到当时的包 | 制品入库并绑定版本 | 产物可检索、可追溯 |
可重复、可追溯、可加速,是这类工具真正交付的三件事。它们最好落在一条链路上,而不是三套互不相通的系统。
二、缓存省下的是什么:不是把编译变快
很多人把构建缓存理解成“让编译更快”,更准确的说法是“让没变的活不再干一遍”。这里要先分清两种缓存:一种是依赖包缓存,把下载过的第三方库留在本地或私服,避免重复下载;另一种是构建缓存,把任务的输出存起来,输入一致时直接复用。前者省网络,后者省计算。
Gradle 官方文档对构建缓存的说明很直接:缓存可以存在本地或远端,当输入没有变化时,构建直接从缓存获取输出,跳过重新生成;共享缓存还能跨开发机和构建节点复用。缓存键由任务类型、类路径、参数、插件版本和构建脚本等内容共同决定,所以它判断的是“这次输入与上次是否一致”,不是“任务名字是否相同”。
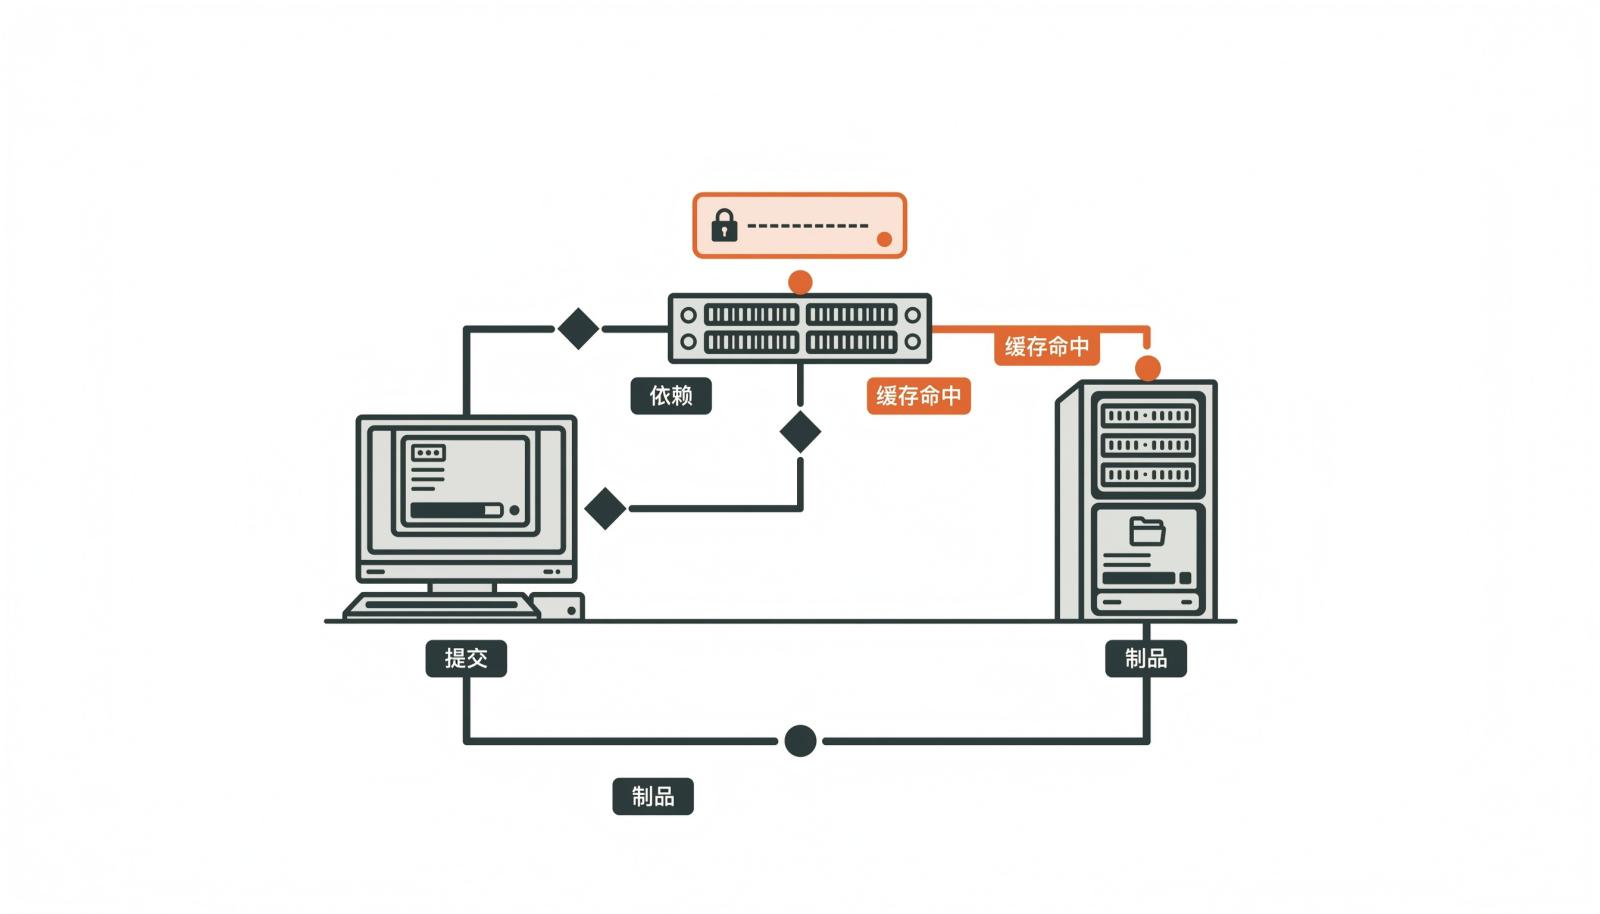
缓存不是免费的。任务输入或输出声明不完整,可能出现错误的缓存命中:两次不同的构建被当成同一次,拿到的却是旧结果。落地时要检查缓存键覆盖了哪些输入、清理和失效策略是否明确,以及缓存命中后是否仍能通过测试验证。
三、为什么依赖要放进私服,而不是每次从公网拉
私服是企业自己维护的仓库服务,通常承担三件事:代理公共仓库并缓存下载过的依赖;托管团队内部发布的包和组件;用一个统一地址承接项目构建请求。这样,开发机和 CI 不需要各自记住多个公网源,内网环境也能稳定拿到依赖。
私服的价值不只是“快”。公共仓库偶发不可用、跨境网络波动、内部包不能公开、依赖需要安全扫描和访问审计,这些都需要一个企业可控的入口。尤其在金融、政企、军工等内网场景,构建过程可能完全不允许访问公网,私服就是依赖的唯一来源。
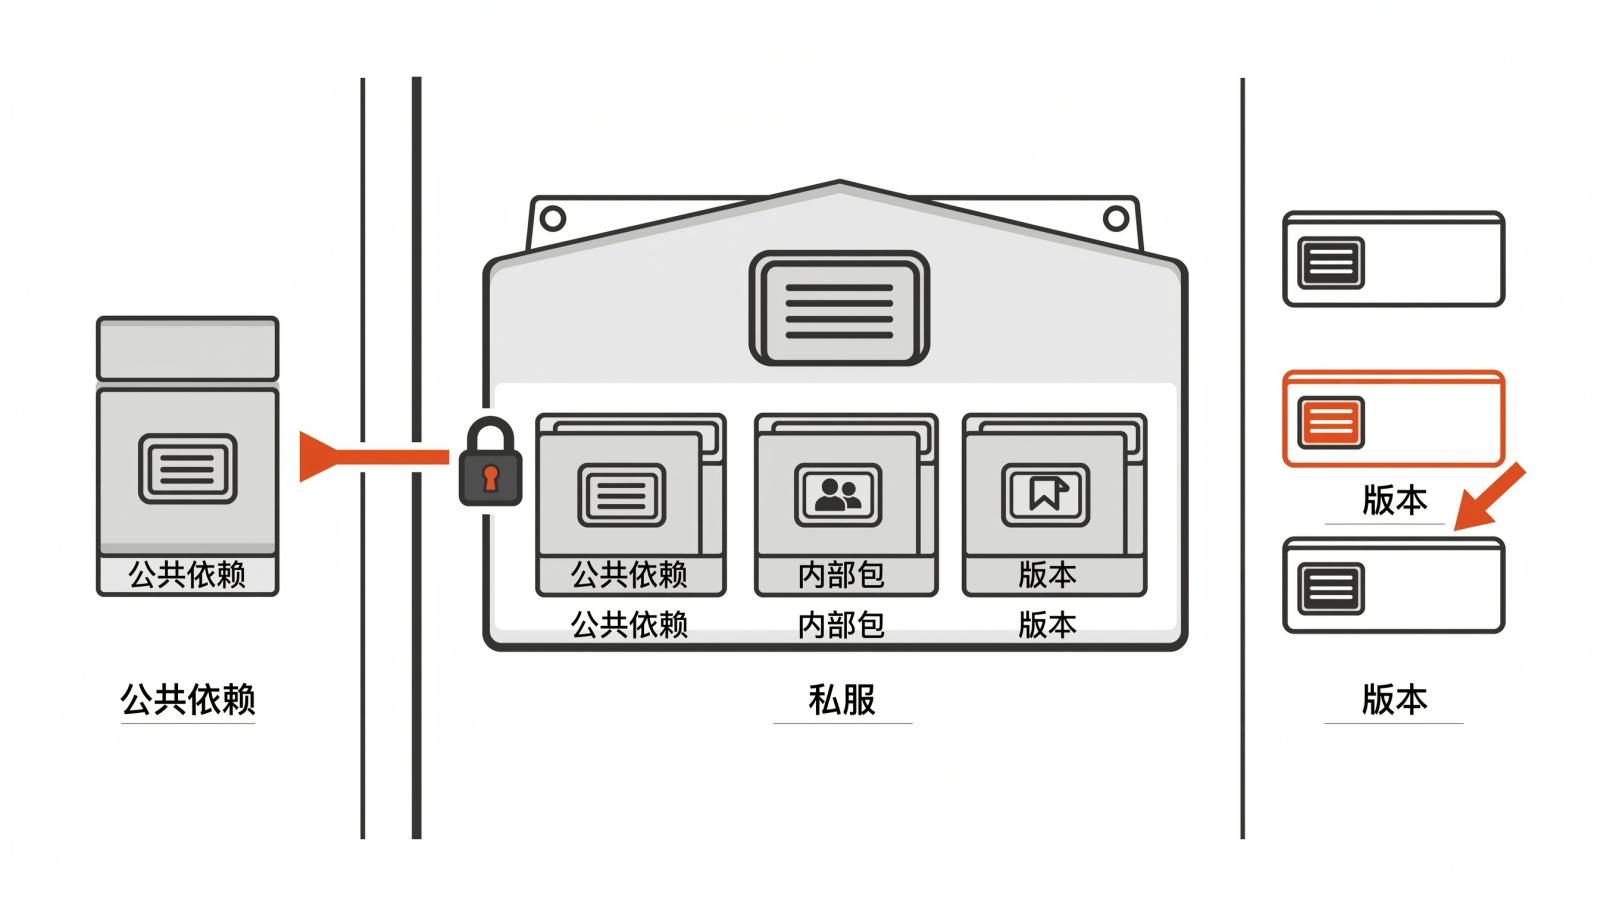
需要留意的是包名冲突。内部包与公共包同名时,如果解析顺序不清楚,构建可能拉到错误来源。常见做法是给内部包固定命名空间,明确私服与公共仓库的优先级,并把仓库配置写进项目而不是留在个人机器上。
平台内置的制品库可以统一管理 Docker、Helm、Maven 和通用文件等制品类型,并提供版本检索、权限隔离和构建来源追溯,适合把“能存”推进到“可查、可控、可回滚”。
四、版本定不住,构建与依赖管理工具做了什么
版本这件事有两层,经常被混在一起。第一层是依赖版本,也就是项目引用的第三方库或内部组件是什么版本;第二层是制品版本,也就是这次构建产出的安装包、镜像或前端静态包是什么版本。前者决定构建输入,后者决定交付结果。
依赖版本靠范围声明很容易漂移。今天解析到 2.3,明天公共仓库发了 2.4,构建结果就可能变。锁定版本的做法包括锁文件、依赖管理段和统一的 BOM。遇到多个版本同时出现时,也不是“版本号大的赢”。Maven 官方规则是最近优先:依赖树中离项目更近的版本被采用,深度相同时先声明者胜。排查时用 mvn dependency:tree 看清路径,比凭经验猜更可靠。
制品版本则要尽量不可变。发布版本一旦入库,就不应该被同名覆盖;每次构建应有可区分的版本号,并与提交记录、流水线执行记录绑定。命名、保留和追溯规则可以直接参考制品版本管理的落地做法。
五、三者接成一条链路,交付才可复现
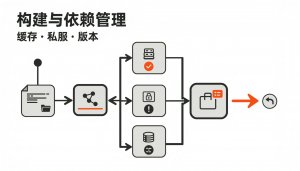
把缓存、私服和版本放在一起,链路就清楚了:提交代码后,构建从私服解析依赖;未变化的步骤命中缓存;产物带上唯一版本进入制品库;部署按版本取包;出问题按版本回滚。每一段都有明确输入和输出,排错时不用在多套系统之间猜。
DORA 的年度报告一直用变更前置时间、部署频率、变更失败率和失败恢复时间观察交付表现。这类指标可以用来检验改动是否有效:构建时长看 p95 而不是平均值,依赖解析失败率和缓存命中率一起看,回滚耗时单独记录。
如果团队正在把 GitLab、Jenkins 和第三方制品库拼在一起,流水线与制品库在同一平台内,权限、审计和版本数据不用跨系统对齐,链路会短一些。构建慢和依赖冲突的具体排查顺序,可以接着看构建慢与依赖冲突的排查顺序。
六、构建与依赖管理工具的落地检查项
同一提交在本地与 CI 解析出一致的依赖树,锁文件或 BOM 进入版本库。
公共依赖统一走私服,私服具备代理缓存、内部包命名空间和访问权限。
构建缓存键覆盖任务输入、插件版本和构建脚本,错误命中有抽查机制。
发布制品版本不可覆盖,版本号与提交、流水线记录绑定,保留策略明确。
观测构建时长 p95、依赖解析失败率、缓存命中率和回滚耗时,用同一口径对比改动前后。
选型阶段不必一次铺开。用一个真实项目做 PoC,把依赖解析、缓存复用、制品入库和回滚各跑一遍,再决定是否需要平台化。需要看实际链路时,可以预约演示或申请试用。
七、结语
构建与依赖管理工具的价值,不是多一个构建按钮,而是让同一份提交在任意节点得到同样的结果,出了问题能回到确定的版本。先把依赖来源、缓存键和制品版本定住,再谈流水线编排和效能度量,顺序会更稳。
八、常见问题
缓存和私服是一回事吗?
不是。私服解决依赖从哪里取、内部包放在哪里;缓存解决下载过或构建过的内容能不能复用。两者经常配合,但职责不同。
有了私服,还需要锁定依赖版本吗?
需要。私服保证来源可控,锁文件保证同一次提交解析到同一组版本。少了任何一个,构建仍可能漂移。
依赖冲突是不是选版本号高的就行?
不一定。Maven 默认按最近路径选择,不看版本号大小。应显式声明需要的版本,再用依赖树确认实际生效的版本。
十几人的小团队需要私服和构建缓存吗?
看协作方式。如果只有一两个项目、依赖简单,先做好版本锁定也能维持;一旦出现多人共用组件、内网构建或频繁回滚,私服和缓存带来的收益会更明显。