


一文读懂代码安全扫描工具能发现哪些问题?
从SAST、SCA、密钥扫描、IaC扫描和DAST的实际检查对象出发,说明代码安全扫描工具能发现的不安全编码、依赖漏洞、泄露凭据和配置问题,并拆解业务逻辑、设计缺陷、运行时上下文与规则滞后造成的盲区,给出判断扫描可信度和组合使用的工程方法。
代码安全扫描工具能发现哪些问题?在 GitFox 的代码评审和交付流程里,团队会先看到一批可被规则、特征或已知漏洞库描述的代码缺陷,但扫描通过并不能单独证明系统安全。
静态扫描、依赖分析、密钥扫描、基础设施配置扫描和动态扫描各管一段;真正容易漏掉的,是业务逻辑、设计假设、运行时上下文,以及尚未进入规则库的新问题。
一、代码安全扫描工具不是一个工具
很多团队把 SAST、SCA、密钥扫描、配置扫描和 DAST 都叫代码扫描,但它们的检查对象并不相同。
SAST:静态应用安全测试,不运行程序,直接分析源代码和控制流、数据流,擅长发现不安全的编码模式。
SCA:软件成分分析,读取依赖清单、锁文件和制品信息,找出第三方组件的已知漏洞和许可证风险。
密钥扫描:在代码、提交历史和配置文件中寻找硬编码的账号、令牌和私钥。
IaC 扫描:检查 Terraform、Kubernetes 等基础设施配置中的错误设置。
DAST:动态应用安全测试,模拟外部请求测试正在运行的应用,能补充一部分运行期问题。
这些工具的共同点是:只能检查它接入的资产、理解的语义和覆盖到的运行状态。仓库外的脚本、未入库的配置、只在生产出现的状态,不会自动出现在报告里。
二、代码安全扫描工具通常能发现哪些问题?
第一类是不安全的编码模式,例如 SQL 注入、跨站脚本、命令注入、路径穿越、不安全反序列化和弱加密。静态工具会把可疑的数据流、危险函数调用和缺失的校验标出来。
第二类是第三方组件的已知漏洞。安全漏洞扫描工具通过依赖关系和版本比对,能发现直接依赖、传递依赖中的公开漏洞,也能提示许可证不兼容和组件长期未更新。
第三类是泄露的凭据。密钥、访问令牌、数据库密码一旦进入代码库,扫描通常可以按已知模式或组织自定义规则识别,部分工具还会对历史提交做回溯检查。
第四类是基础设施和容器配置错误。公开可读的对象存储、过大的权限、特权容器、过宽的入站规则,都属于适合自动检查的重复性问题。
第五类是部分运行期问题。DAST 可以观察应用的实际响应,发现暴露的接口、错误的认证行为和某些安全配置问题,但覆盖程度取决于测试账号、业务路径和环境准备。
需要强调的是:扫描结果是候选问题,不是可利用性证明。同一条告警是否真实、是否重要,还要结合调用链、暴露面和数据敏感度判断。
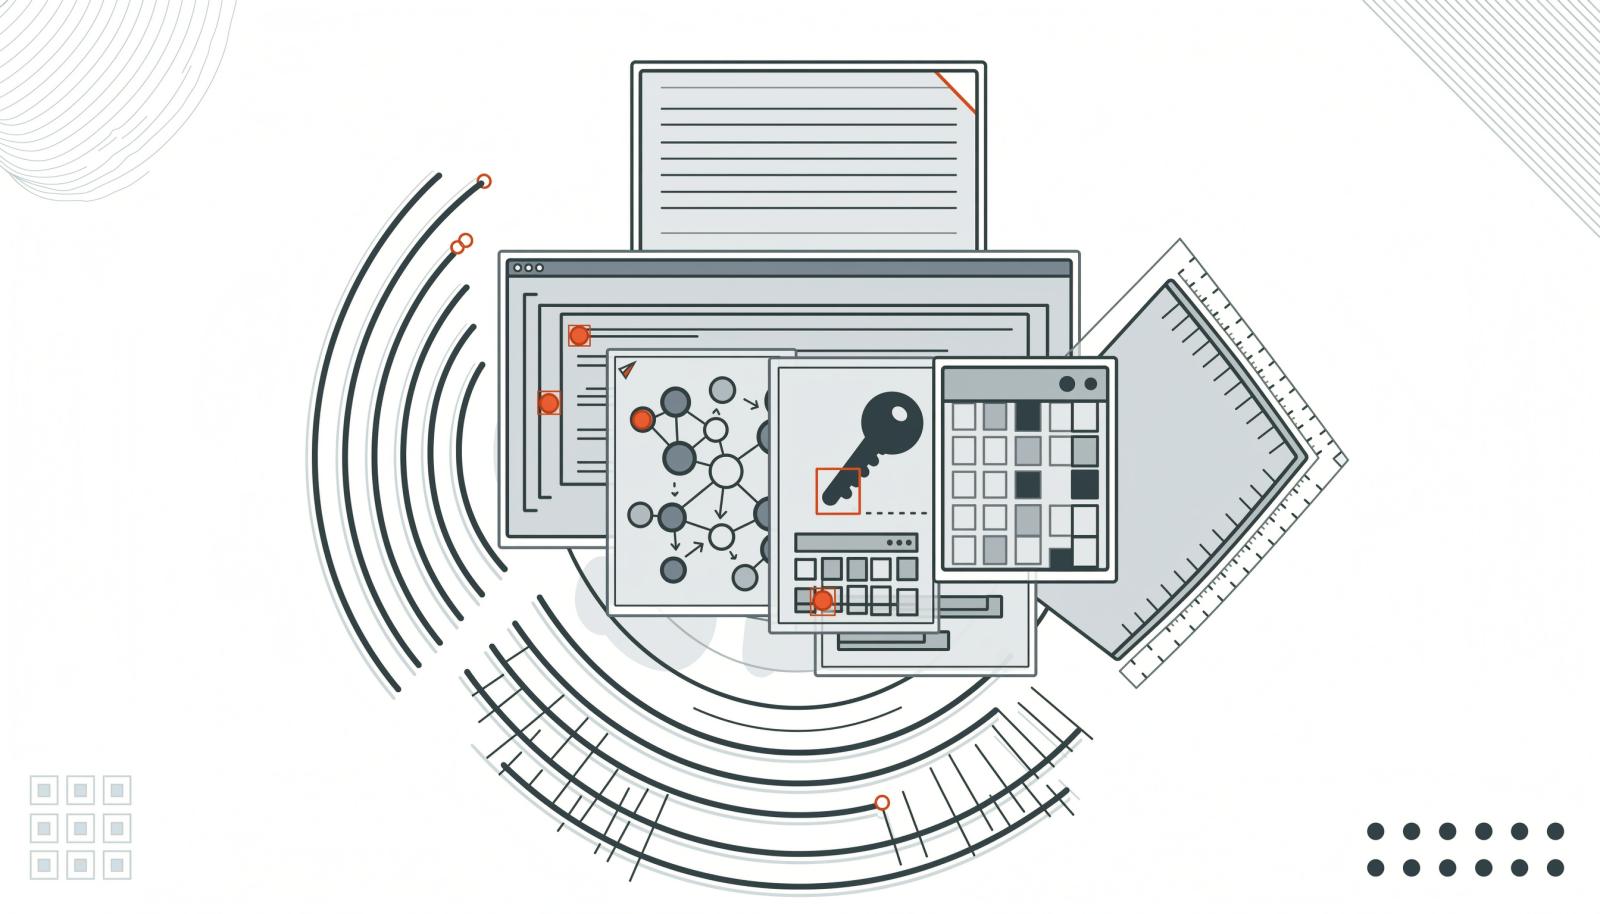
图1:不同扫描层各自覆盖一部分资产,也都存在边界。
三、哪些问题代码安全扫描工具查不到?
业务逻辑漏洞是最典型的盲区。改价格、重复领券、绕过审批、超卖库存,这类问题往往由多个正常操作的组合触发。比如订单金额由客户端传入,代码里也做了格式校验,但真正的业务约束是服务端必须重新计算价格;扫描器能看到校验函数,却不知道这条规则。PortSwigger 的 Web Security Academy 也指出,这类缺陷通常与应用的具体功能强相关,识别时需要理解业务域和攻击目标,因此很难靠自动化扫描器独立发现。
设计缺陷和权限模型问题也容易被漏掉。代码可能完全符合某种安全写法,但信任边界画错了、租户隔离方案不成立、权限判断放在错误的层级,扫描器仍然不会报警。它看到的是代码片段,不是完整的系统设计。
未知漏洞和新攻击链同样超出规则库的能力。依赖扫描依赖已知漏洞数据库,SAST 依赖规则和查询,数据库和规则没有收录的问题,自然无法稳定命中。规则更新还有时间差。
实际可利用性需要运行时上下文。一个存在漏洞的函数可能根本没有被调用,也可能只在内网、低权限或没有敏感数据的环境中使用;反过来,看似低危的问题可能正好暴露在互联网入口。缺少调用链、部署拓扑和真实流量,工具很难给出最终结论。
生产状态和配置漂移也不在静态文件的覆盖范围内。IaC 扫描能检查模板,却不一定知道线上资源是否被手工改动;密钥扫描能检查仓库,却看不到 CI 变量、第三方平台和运行环境中的凭据。
此外,生成代码、编译产物、厂商提供的二进制组件、冷门框架和自定义封装,都可能让扫描覆盖率下降。报告没有告警,只说明“没有在已检查范围内发现”,不等于“没有问题”。
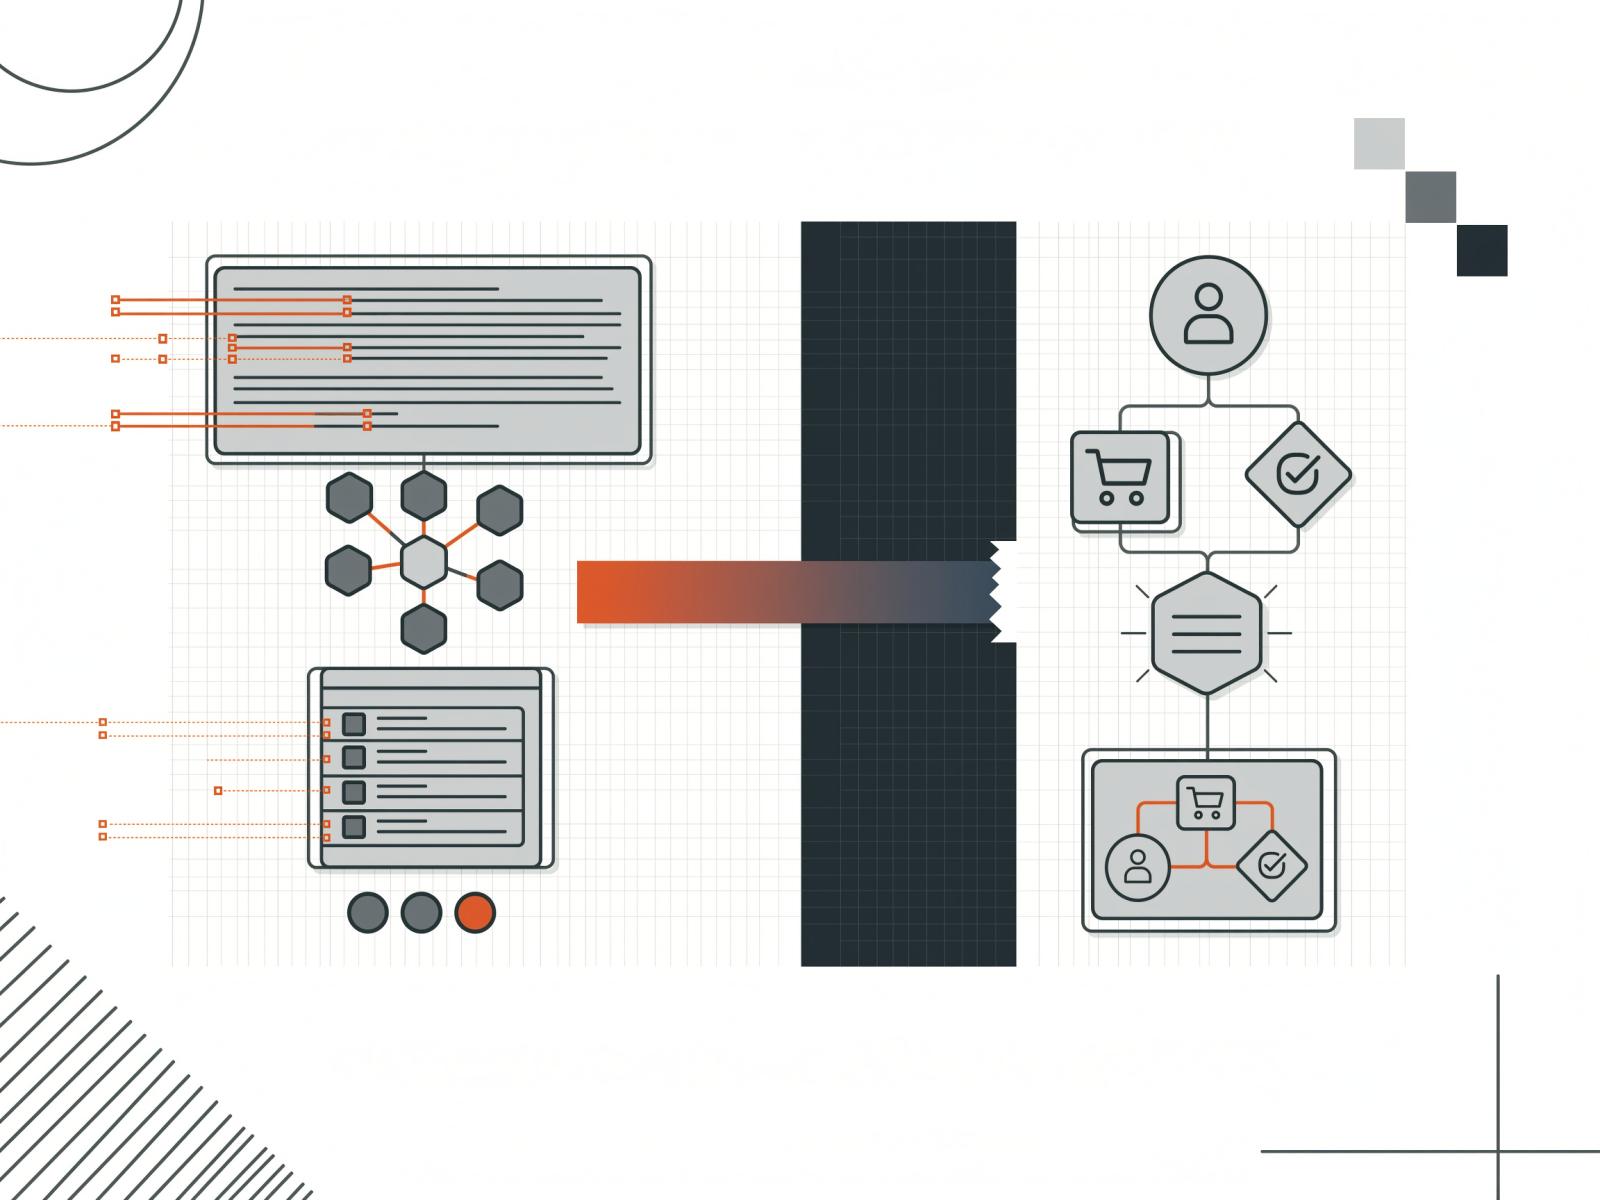
图2:自动化擅长检查代码与依赖,业务逻辑和运行上下文仍需人工补位。
四、为什么扫描报告会漏掉?
漏报通常不是单点故障,而是几个环节叠加的结果。
范围不全:只扫增量、跳过测试和配置文件、没有回溯历史提交,都会留下空白。
语义理解有限:自定义框架、反射调用、动态拼接 SQL、包装过的校验函数,可能让数据流分析断链。
构建不真实:代码编译失败、依赖缺失、数据库结构不一致,扫描只能降级运行。
漏洞情报和组件清单不完整:新披露漏洞、内部组件和软件物料清单识别不准,都会影响匹配结果;数据库更新不及时,漏报就会持续存在。
运营配置抵消了检查:基线、排除项、严重级别阈值和忽略告警,可能把真实问题一起静音。
过度追求低误报:规则调得更保守,噪音少了,敏感度也可能一起下降。
所以,看到“扫描通过”时,更应该问:扫了哪些资产、用了什么规则、在哪个环境运行、哪些告警被排除。
五、怎样判断代码安全扫描是否可信?
可以用五个问题做验收:
覆盖是否说清楚:支持哪些语言和框架,是否覆盖直接与传递依赖、历史提交、密钥、IaC 和容器。
证据是否可复核:能否给出文件、行号、数据流路径,或请求与响应,让开发人员复现。
优先级是否合理:是否考虑可达性、互联网暴露、敏感数据和攻击前置条件,而不是只看评分。
流程是否闭环:是否接入合并请求和构建门禁,是否有负责人、修复期限和例外到期机制。
效果是否被验证:是否统计确认的真实问题、修复时长和漏到线上的缺陷,而不是只统计告警数量。
高风险模块还应安排人工评审、威胁建模或渗透测试。自动扫描负责规模化和重复性,人工负责理解业务语义和攻击组合。
六、把扫描放回研发流程
比较合理的组合是:提交前做密钥检查,合并请求阶段跑 SAST 和 SCA,构建阶段检查镜像与 IaC,测试环境用 DAST 验证运行期问题,上线前对高风险模块做人工评审,上线后结合日志和运行时防护观察异常。每一层解决不同问题,不要求某一层包打天下。
如果代码托管、评审和流水线本来就在一个平台里,扫描结果更容易落到具体提交和合并请求上。GitFox 作为禅道 DevOps 的内置核心组件与一体化底层引擎,把代码扫描接入代码仓库和交付流水线;它与禅道项目管理分工衔接,底层代码自研,不依赖海外开源内核。对团队来说,关键不是多一个报告页,而是让扫描结果进入合并门禁、缺陷流转和版本追溯。
回到开头的问题:代码安全扫描工具能发现的是可模式化、可比对、可定位的缺陷;查不到的是业务逻辑、设计假设、真实运行状态和尚未被认识的新风险。它是筛查手段,不是安全结论。真正可靠的用法,是知道每一层扫描回答什么问题,再用人工评审、威胁建模和运行时验证补齐空白。
七、常见问题
代码安全扫描工具能替代人工安全测试吗?
不能。它擅长规模化检查可模式化的问题;业务逻辑、权限设计和高风险攻击路径,仍然需要人工评审、威胁建模或渗透测试。
扫描告警越多,说明风险越高吗?
不一定。告警数量不等于风险高低。先看问题是否可达、是否暴露在互联网、是否接触敏感数据,再安排修复顺序。
SAST、SCA、DAST 需要全部启用吗?
取决于资产和流程。只要涉及源代码,通常应先覆盖 SAST 和 SCA;有运行中的应用,再补 DAST;使用容器和 IaC 时,还要检查镜像与配置。


相关阅读
更多博客 → 开源测试工具和商业测试平台怎么选?
从测试链路断点、五项判断标准、三种典型场景和两周 PoC 出发,说明开源测试工具与商业测试平台如何按团队能力、合规要求、...
 自建监控还是买现成的?按规模与运维能力判断
从监控边界、指标规模、运维所有权、总成本与退出风险出发,比较自建与采购现成监控方案的适用条件,给出三类团队的选择路径和四...
 2026 DevOps 工具全景图:AI 进场后,这 7 类工具重新洗牌
2026 DevOps工具全景:AI驱动编码审查、CI/CD、IaC、智能化测试、AIOps、DevSecOps与事件响...
 什么是 DevOps 平台?别再把它和 Jenkins 搞混了
别再混淆DevOps平台与Jenkins、CI/CD!本文详解DevOps平台定义、与CI/CD的全维度对比、适用团队及...