


镜像漏洞扫出来一堆,如何排优先级?
镜像漏洞的修复顺序不该只按 CVSS 分数排。文章用 KEV、EPSS、运行暴露、组件可达性和修复可用性五个信号,配合镜像聚合、四档处置与流水线门禁,把一长串 CVE 变成可执行的修复计划。
扫描报告一打开,几百条 CVE,Critical 一排红。团队按分数从高到低修,两周过去,工单关了不少,线上真正可能被利用的入口还在。问题通常不在扫描器,而在把漏洞的通用严重度,直接当成了修复顺序。
镜像扫描工具给出的结果,通常是一张按 CVE 排列的清单;而修复要面对的是服务、镜像和发布窗口。下面这套方法用五个信号排序,再落成四个处置档位,最后接进流水线,适合 50~300 人的研发中心和私有化容器环境。
一、CVSS 分数高的镜像漏洞,不一定要先修
CVSS 是 FIRST(事件响应与安全团队论坛)维护的通用漏洞评分标准,当前版本为 4.0,用 0~10 分描述漏洞严重度,帮助组织评估和排序漏洞管理流程。扫描器给出的往往只是基础分,而 CVSS v4.0 还提供威胁指标和环境指标,后者需要结合部署环境调整。
直接按分数排期,会遇到三个问题。
第一,分数描述漏洞,不描述资产。一个 9.8 分的组件如果在多阶段构建中已被丢弃,不在最终镜像里,处置顺序就不该和运行中的公网服务一样。
第二,同一个 CVE 会在多个镜像和服务中重复出现。按条目排行,看到的是一堆重复项,不是可执行的修复任务。
第三,分数不含时间。是否已有在野利用、PoC 是否公开、补丁是否可用,都会改变先后。
CVSS 适合做第一道筛选,不适合直接当排期表。
二、镜像扫描工具报了一堆,先看 KEV、EPSS 和暴露面
把“严重”变成“该先修”,要补上五个信号。它们不是简单加权,而是逐层排除明显不该抢修的项。
信号 | 回答的问题 | 典型数据 | 对顺序的影响 |
|---|---|---|---|
已知利用证据 | 是否已被利用 | CISA KEV 目录 | 命中且暴露,进入 P0 |
利用概率 | 未来 30 天被利用概率 | FIRST EPSS 分数与百分位 | 高概率但未入 KEV,提前复核 |
运行暴露 | 是否在生产、公网或敏感数据旁 | 环境标签、网络策略、权限 | 生产且可访问,上调 |
组件可达性 | 最终镜像是否包含、运行时加载、输入可触达 | 镜像层、SBOM、启动依赖、调用链 | 不可达可降档,但保留记录 |
修复可用性 | 是否有官方修复版本、能否低成本重建 | 修复版本、基础镜像版本、变更窗口 | 决定立即修还是先补偿 |
已知利用证据是硬信号。 CISA 的 KEV(已知被利用漏洞目录)收录已确认在野利用的漏洞,命中它说明风险不是假设。EPSS(漏洞利用预测评分)则是预测信号:按 FIRST 的定义,它估计某个公开漏洞在未来 30 天内被观察到利用活动的概率,并给出百分位。两个常见误读是:EPSS 不是“你这台主机被攻破的概率”,百分位也不是概率。 它更适合在未入 KEV 的漏洞里,找出更值得优先复核的一批。
运行暴露和组件可达性,回答“这个漏洞在你的环境里能不能被碰到”。同一个反序列化漏洞,放在只处理内网定时任务的容器里,和放在接收公网请求、挂载敏感配置的容器里,处置顺序不应相同。
修复可用性决定动作类型。有官方修复版本、且只需升级基础镜像再重建,通常可以快速闭环;没有修复版本,就要转入补偿控制和例外管理,而不是让工单无限期挂着。
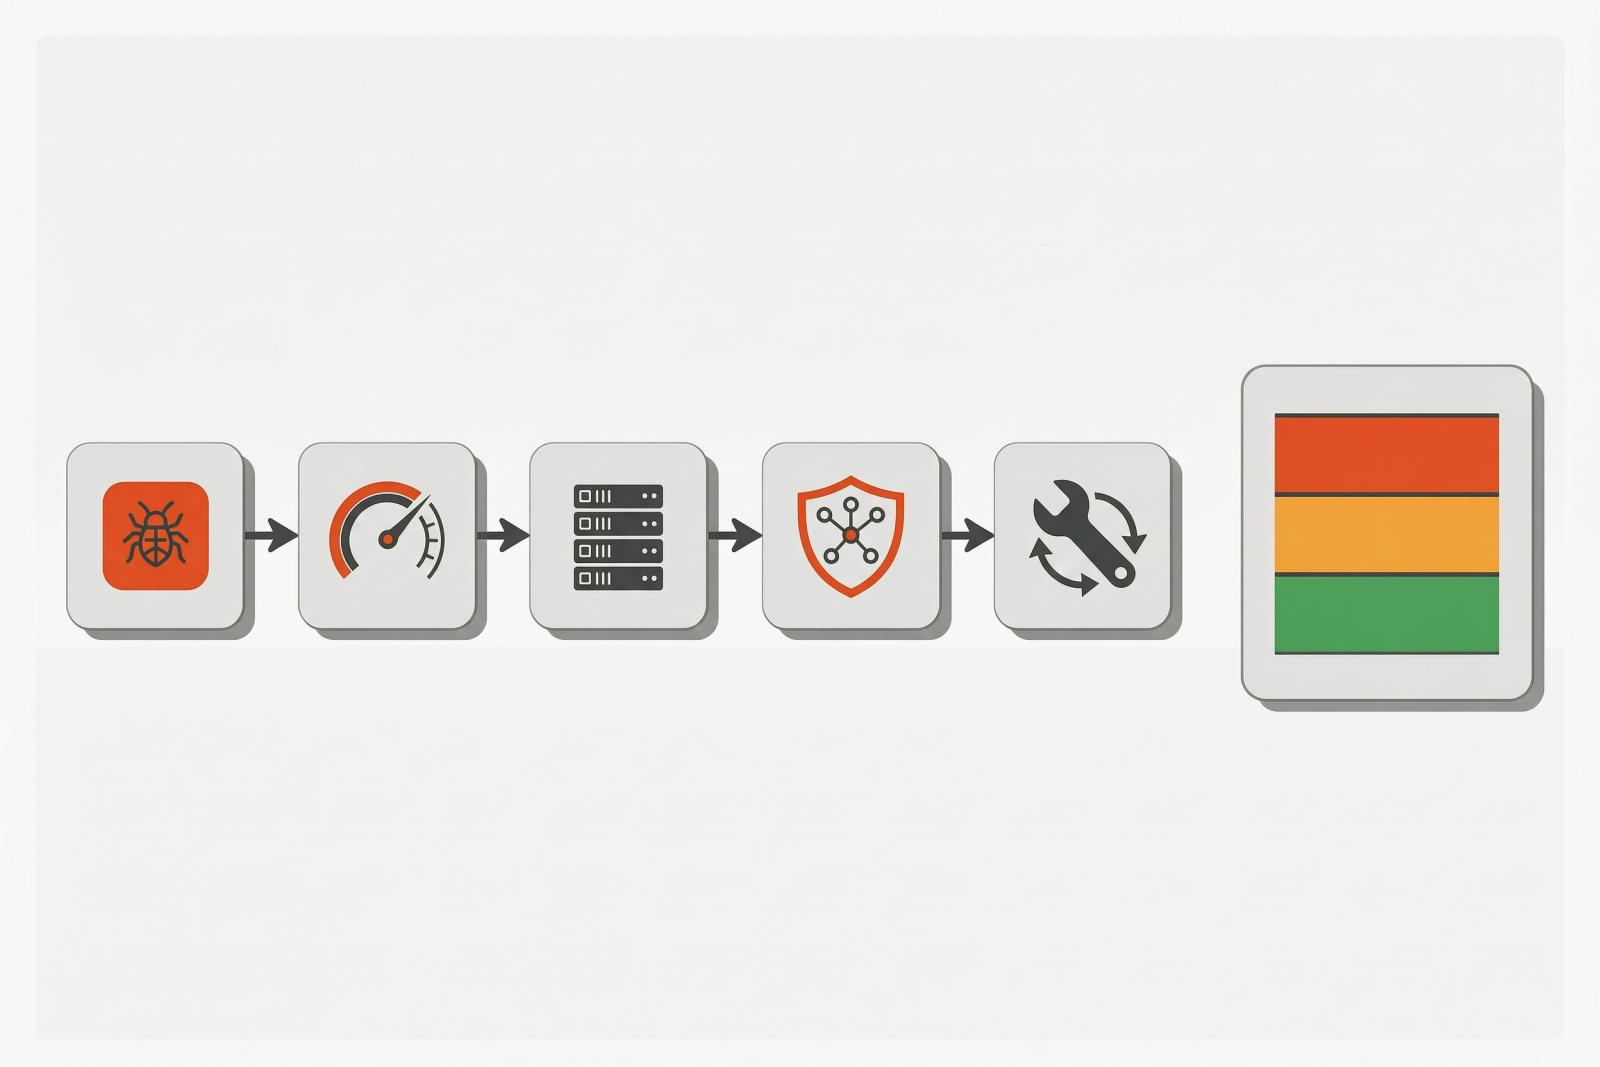
图 1:五个信号逐层收敛,把一长串 CVE 收敛成可处理的修复单元
三、镜像漏洞按基础镜像归并,优先级才排得清
单条镜像漏洞判断完,还要回到镜像维度聚合。镜像扫描工具的输出不是工单列表,而是一组需要聚合的原始记录。一个基础镜像往往被十几个服务复用,升级一次,可能同时消掉几十条重复告警。建议按“基础镜像 digest → 受影响服务 → 运行环境 → 责任人”建清单,把 CVE 条目合并成修复单元。
然后按后果分档,而不是按分数分档。
档位 | 典型条件 | 动作 | 建议时限 |
|---|---|---|---|
P0 立即 | 已确认在野利用,或高概率利用,且生产暴露、组件可达 | 阻断发布,升级或下线 | 24 小时内启动 |
P1 本迭代 | 高严重度且生产暴露,有可用修复版本 | 排入当前迭代,重建复扫 | 7 天内 |
P2 排期 | 生产但不可达、权限受限,或仅测试环境 | 纳入版本计划,随基础镜像升级 | 30 天内 |
P3 观察/例外 | 无修复版本、构建期依赖、已有补偿控制 | 记录依据,设到期日,触发复评 | 按例外审批 |
时限是建议起点,不是行业统一标准,可以按业务影响和团队规模调整。关键是同一档位对应同一套动作,避免每个漏洞都重新开会。
四、漏洞优先级不接进流水线,两周后还是人工表
排序结果不进入构建和发布流程,过两周又会回到人工表格。NIST SP 800-190《应用容器安全指南》把容器安全覆盖到构建、分发和运行三个阶段,这也解释了扫描为什么不能只在发布前做一次。比较稳妥的做法,是把扫描放到四个位置:构建完成后、推送制品库前、部署前、运行中定期复扫。前三个位置拦截新增风险,最后一个处理存量镜像和基础镜像的新披露。
门禁规则要和档位对应。P0 直接阻断,P1 允许继续但自动生成工单和到期提醒,P2 只记录,P3 走例外审批。这样安全团队不必每天追着研发改报告,研发也知道什么情况下会被卡住。
版本追溯同样重要。镜像 digest、SBOM、扫描结果、修复版本、发布记录要能串起来,否则容易出“报告里修了、线上还在跑旧镜像”的情况。
代码侧先收口。代码安全扫描 可以在提交和合并阶段发现问题,减少带病进入构建的概率。
构建与发布环节,CI/CD 流水线 把构建、扫描、门禁按顺序串起来,避免人工在多个平台之间搬运结果。
镜像产出入库时,制品库 保存 Docker 镜像、版本和 digest,后续复扫和回滚都有据可查。
是否放行由质量门禁 决定,规则固定后,研发能预期什么情况会被卡住。
GitFox 是禅道软件全自研的一体化 DevOps 底层引擎,也是禅道 DevOps 方案的内置核心组件,底层不依赖海外开源内核。它与禅道的分工边界清楚:禅道承接需求、任务、缺陷和项目协同,GitFox 承接代码托管、评审、流水线、制品和发布,两边通过需求、提交和缺陷关联追溯。对需要私有化或信创适配的团队,这种一体化底座可以减少多套工具拼接带来的版本对不上和权限分散。
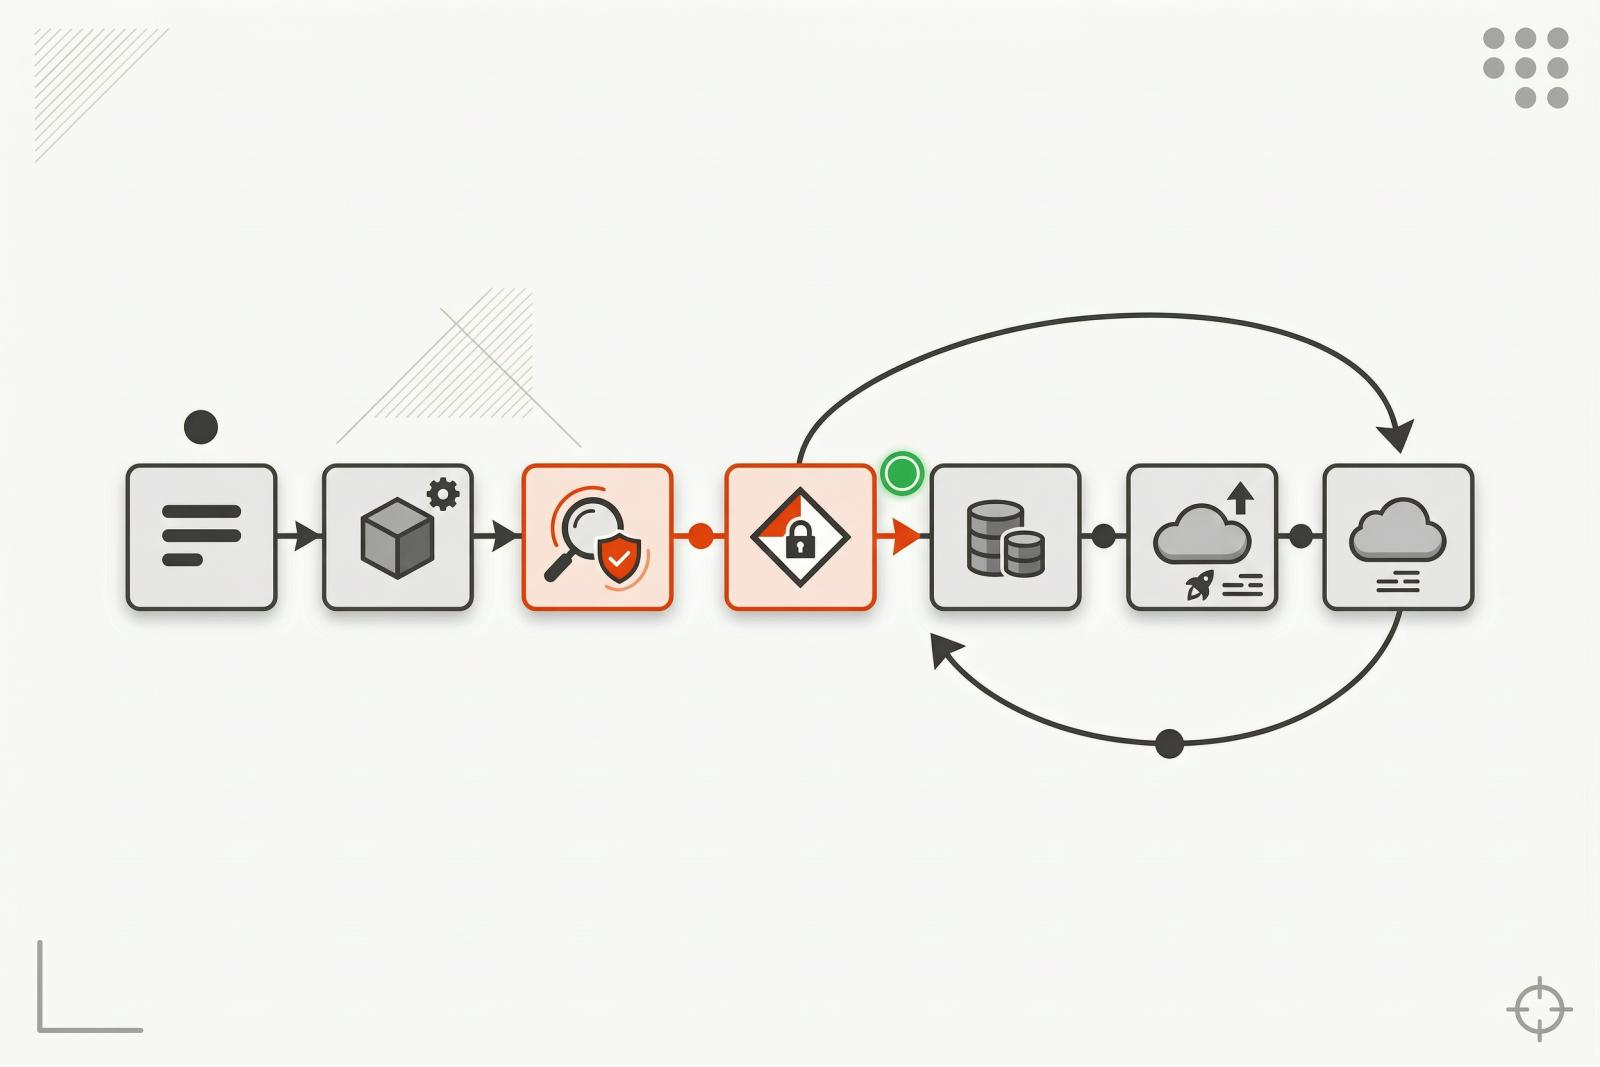
图 2:把扫描、门禁、制品入库和复扫接成一条可追溯的链路
五、容器镜像安全里的例外,怎么留得清楚
总有一部分漏洞暂时修不了。没有修复版本、依赖上游、或者修复会破坏兼容性,这些情况需要例外管理,而不是直接关闭。
例外至少记录四项:风险依据、补偿控制、责任人、到期日。 补偿控制可以包括限制网络访问、降低运行权限、只读文件系统、运行时防护等。到期日不是形式,镜像更新、基础镜像切换、漏洞状态变化时都要触发复评。
责任也要分清:安全团队定规则和阈值,平台团队维护基础镜像和流水线,业务团队修应用依赖,运维团队管运行时暴露面。
六、镜像扫描工具相关问题
1. Critical 多,是不是就该先修 Critical?
不一定。Critical 表示通用严重度高,不表示它已经在生产环境中可被触达。先看利用证据,再看运行暴露和可达性。
2. EPSS 高,就要立即修吗?
EPSS 高说明未来 30 天被观察到利用的概率较高,可以作为提前复核的理由。但它不预测你的主机是否被攻破,仍要结合 KEV、暴露面和修复成本。
3. 没有修复版本怎么办?
转入补偿控制和例外管理,记录责任人、到期日和复评触发条件。不要把工单长期挂着,也不要用“无修复版本”直接关闭。
4. 测试环境的漏洞可以先不管吗?
要看它是否与生产共用基础镜像、是否持有真实数据、是否能访问生产网络。共用基础镜像的漏洞,往往一次升级就能覆盖多个环境。
七、镜像漏洞优先级,最后要落到能执行的顺序
镜像漏洞的优先级,不是把 CVSS 从高到低排一遍。更可执行的顺序是:先用 KEV 和 EPSS 判断利用可能性,再用运行暴露和组件可达性判断实际后果,最后用修复可用性决定动作。落到执行层,就是按镜像聚合、按档位分派、把门禁和追溯接进流水线,并给暂时修不了的漏洞留下有期限的记录。
选镜像扫描工具只是起点,排序和闭环才决定它能不能产生价值。如果团队正在把代码扫描、构建、制品和发布串成一条链路,可以在 GitFox 私有化环境中做一次小范围验证:选一个基础镜像,跑通构建、扫描、门禁、入库、复扫五个环节,再决定是否扩大范围。预约演示或试用,按现有流水线验证即可。


相关阅读
更多博客 → 开发嫌安全扫描慢,DevSecOps 平台怎么平衡?
从开发等待扫描的真实场景出发,拆解安全扫描慢的触发粒度、门禁设置与平台能力原因,给出三层扫描、分级阻断、缓存并行和结果闭...
 分支策略怎么定?主干开发、Git Flow 与发布分支
围绕主干开发、Git Flow 与发布分支三种做法,按发布节奏、并行版本和维护成本建立选择标准,并给出 Web/SaaS...
 DevSecOps落地第一步:如何将5类代码扫描嵌入CI/CD流水线
面向研发负责人与 DevOps 工程师的实践指南:先讲清为什么 DevSecOps 落地要从安全左移、把代码扫描嵌入 C...
 AI代码进链路后,代码全生命周期管理怎么一条链跑通
解析AI代码进入研发链路后,代码全生命周期管理如何打通提交、CI、评审、测试部署七站,实现规格驱动生成、预检前置、需求I...